WNC LogoWNC
ServicesSolutionsEntrepriseAcadémieLabsContact
Ouvrir Kanban

We No Code. We Architect.

Démarrer un projet daniel@we-nocode.com
WNC LogoWNC

Partenaire IA & automatisation. Conçu avec soin aux États-Unis, en Pologne, en Estonie, au Brésil et en Ukraine.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
100 % à distance, partout dans le monde

Solutions

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portails

  • Portail client
  • Portail investisseurs
  • Portail partenaires

Entreprise

  • À propos
  • Notre équipe
  • Études de cas
  • Témoignages
  • Investissement
  • Blog
  • Actualités
  • Carrières
  • Implantations
  • Contact

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Initiatives

  • Startup Program
  • Academy
  • Olymp Hill

Services

Tous les services
IA
  • Systèmes d’IA agentique
  • Agents IA & copilotes
  • Serveurs MCP
  • Pipelines RAG
  • Agents vocaux IA
  • Logiciels natifs IA
  • Automatisation des flux de travail
  • LLMOps et evals
  • Fine-tuning et modèles
  • IA documentaire
  • Vision par ordinateur
Développement
  • Développement web
  • Développement mobile
  • Développement SaaS et MVP
  • Design UI/UX et produit
  • Intégrations et APIs
  • Développement e-commerce
  • Modernisation legacy
  • QA et tests automatisés
  • No-code et low-code
  • Développement desktop
Embarqué & IoT
  • Solutions IoT
  • Firmware embarqué
  • Linux embarqué & SoC
  • Edge AI & TinyML
  • Sans fil & connectivité
  • Prototypage matériel
  • Plateforme & cloud IoT
  • Gestion de flotte & OTA
  • IoT industriel (IIoT)
  • Sécurité IoT
Cloud & données
  • Ingénierie des données
  • Infrastructure cloud pour l’IA
  • Développement serveur
  • DevOps et plateformes
  • Migration et FinOps
  • BI et tableaux de bord
  • Analytique de performance
  • Support et SRE
Sécurité
  • Pentest
  • Red teaming IA
  • Conformité
  • Authentification
  • Sécurité du cloud
  • Développement sécurisé
  • Chaîne logicielle
  • Audits de sécurité
  • Surveillance sécurité
  • Zero trust
  • Vie privée et RGPD
Conseil
  • Conseil & accompagnement
  • CTO as a service
  • Stratégie et gouvernance IA
  • Due diligence technique
  • Équipe dédiée
  • Formation IA pour les entreprises
R&D / innovation
  • Preuve de concept & faisabilité
  • Prototypage rapide
  • Recherche en IA appliquée
  • Veille & choix technologiques

© 2026 WNC. Tous droits réservés.

🇺🇦Soutenez l’Ukraine

We No Code

Tous les services

LLMOps, evals et garde-fous

Des fonctions IA que vous pouvez mesurer et croire.

Evals, traces, garde-fous et maîtrise des coûts : la couche d’exploitation des applications LLM.

Lancer une fonction IA est la partie facile ; la garder juste, sûre et abordable quand les prompts, les modèles et les données changent, c’est le vrai travail. Nous mettons en place la couche d’exploitation autour de vos applications LLM : suites d’evals et LLM-as-a-judge qui notent chaque version, traces qui montrent ce que le modèle a vu et fait, garde-fous qui bloquent les entrées et sorties à risque, maîtrise des coûts et de la latence avec routage des modèles, pour une qualité mesurée, pas supposée.
Gérons ensemble Ouvrir Kanban
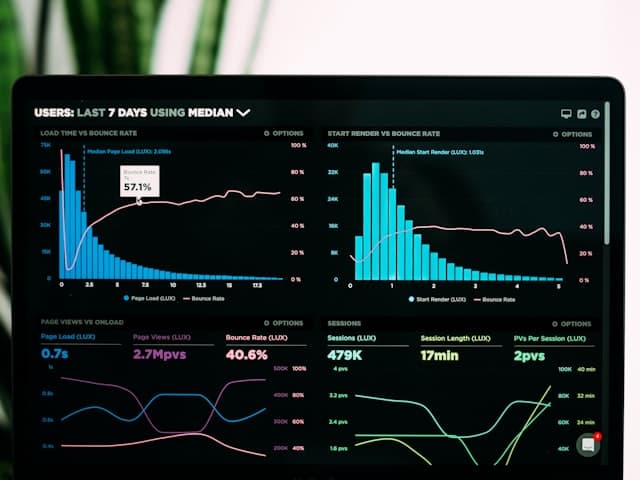
LLMOps dashboards: evals, traces and costs of AI features

01 / Ce que cela résout

De « en démo, ça semblait bien » à une qualité mesurée.

01

Des evals à chaque version

Jeux de référence et juges qui notent exactitude, ancrage, ton et règles, pour qu’un changement de prompt ou de modèle ne dégrade rien en silence.

02

Chaque étape visible

Traces des prompts, recherches, appels d’outils et réponses, reliées aux utilisateurs et aux versions, pour déboguer vite.

03

Des garde-fous qui tiennent

Contrôles de prompt injection, fuite de données, hors-sujet et contenu à risque, en entrée comme en sortie.

04

Coûts et latence maîtrisés

Coût par requête et par fonction, cache et routage vers des modèles plus petits quand la qualité le permet.

02 / Stack

La technologie avec laquelle nous construisons.

Standard du secteur, ennuyeux dans le bon sens : des outils d’avenir, que le prochain ingénieur connaîtra aussi.

Traces et observabilité

  • Langfuse

    Traces et analytique LLM open source

  • OpenTelemetry

    Standard de télémétrie neutre

  • MLflow

    Suivi d’expériences et évaluation

  • Arize Phoenix

    Observabilité LLM open source

Évaluation

  • LLM-as-a-judge

    Notation par un modèle selon des critères clairs

  • Golden datasets

    Jeux de test issus du trafic réel

  • Promptfoo

    Tests de prompts et de régression en CI

  • Ragas

    Métriques de qualité de recherche et de RAG

Garde-fous et contrôle

  • Guardrail models

    Contrôles de sécurité en entrée et en sortie

  • LLM gateway

    Un point d’entrée pour routage, limites et clés

  • Prompt registry

    Prompts versionnés avec retour arrière

  • Semantic caching

    Réutiliser les réponses aux questions répétées

03 / Approche

Comment nous construisons des choses qui durent.

01

Définir la qualité d’abord

Nous convenons avec vous de ce qu’est une bonne réponse et en faisons des critères et des cas de test avant tout réglage.

02

Des evals en CI

Chaque changement de prompt, de modèle ou de données lance la suite ; une régression bloque la version comme un test en échec.

03

Le bon modèle par tâche

Le routage envoie le simple vers de petits modèles économiques et le difficile vers les plus puissants, avec repli.

04

Alertes de dérive

Notation d’un échantillon du trafic réel et alertes quand la qualité, le coût ou la latence bougent.

04 / Standards

Les bonnes pratiques que nous ne négligeons pas.

Nous respectons les standards du secteur et des méthodes éprouvées sur chaque projet : c’est ce qui fait tenir le devis.

  • Jeux de référence construits à partir du trafic réel
  • Juges calibrés sur des annotations humaines
  • Versions de prompt et de modèle dans chaque trace
  • Masquage des données personnelles dans les journaux
  • Tests de prompt injection et de fuite de données
  • Budgets et limites par fonction
  • Modèles de repli en cas de panne
  • File de revue humaine pour les réponses incertaines

05 / Infrastructure

Où ça tourne, et comment ça reste en ligne.

  • Traces de chaque appel LLM et d’outil
  • Suite d’evals en CI et sur un échantillon de production
  • Passerelle LLM avec routage, cache et budgets
  • Tableaux de bord et alertes qualité, coût et latence

Bonnes questions

Ce que l’on nous demande

Des réponses franches aux questions posées avant de démarrer.

Parce que leur comportement change quand on modifie un prompt, qu’on change de modèle ou qu’on met à jour les données, et rien dans une suite de tests classique ne le remarque. Les evals transforment le « ça a l’air d’aller » en qualité mesurée (exactitude, ancrage dans les sources, ton, respect des règles) vérifiée avant chaque version.

Réalisations liées

Là où nous l’avons déjà fait

Nos projets et produits qui ont mobilisé ce service.

Pastukh
Notre produit

Pastukh

Un agent IA de développement propulsé par otara-v0, un modèle que WNC a construit de zéro (ni wrapper ni fine-tune) derrière un seul endpoint compatible OpenAI. En bêta.

AdCrier
Notre produit

AdCrier

Des réponses sponsorisées, payées au clic : une marketplace biface qui relie les apps IA souhaitant monétiser aux annonceurs voulant toucher leurs utilisateurs : enchères CPC directes, ciblage par catégorie, sans réseau tiers.

Agent de support IA + tableau de bord pour un constructeur automobile
Agents IA · Service client

Agent de support IA + tableau de bord pour un constructeur automobile

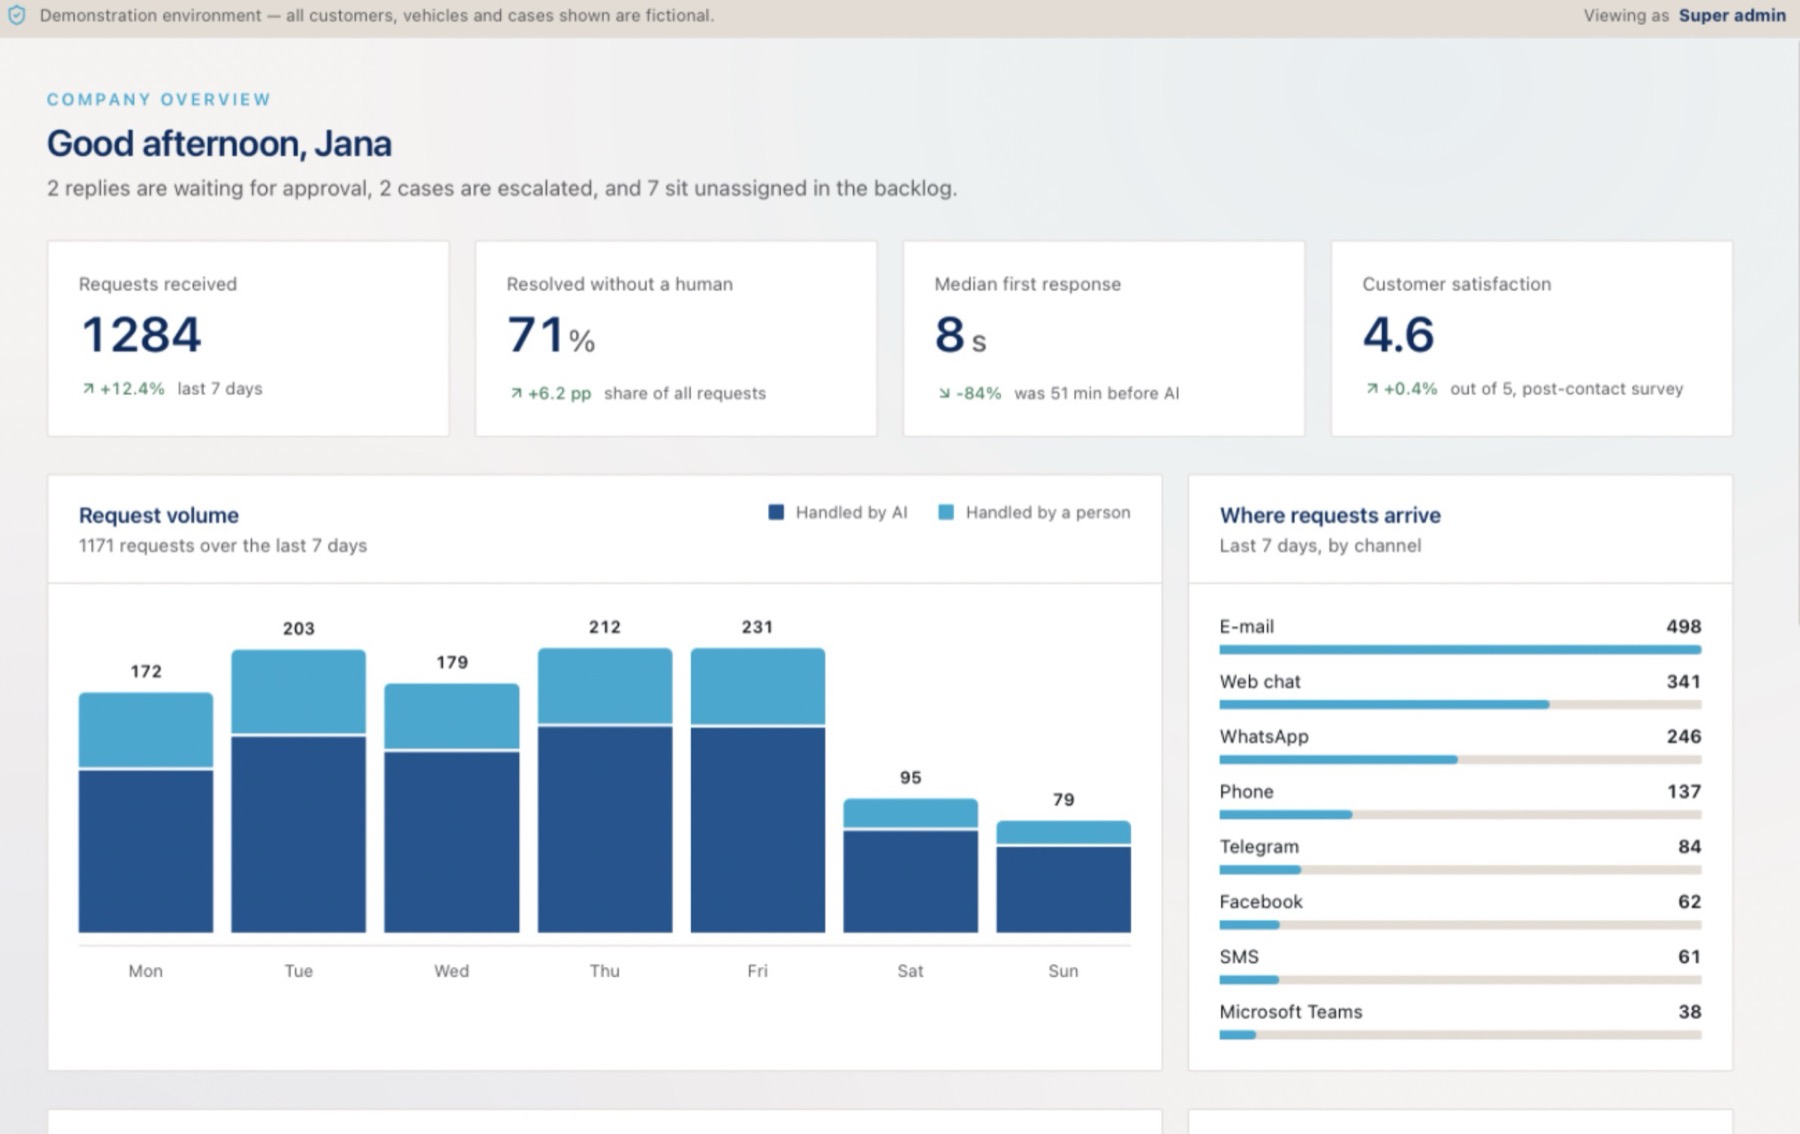
Chaque demande client est lue et classée par l’IA, la fiche du véhicule est récupérée automatiquement et une réponse est rédigée, et rien ne part au client tant qu’un conseiller ne l’a pas validée.

Start

Prêt à savoir ce que vaut vraiment votre IA ?

Dites-nous quelles fonctions IA vous exploitez. Un ingénieur senior vous répond avec un périmètre et un prix honnêtes.

Let’s manage Voir l’analytique de performance