WNC LogoWNC
ServicesSolutionsEntrepriseAcadémieLabsActualitésContact
Partenaire
Ouvrir Kanban
WNC LogoWNC

Partenaire IA & automatisation. Conçu avec soin aux États-Unis, en Pologne, en Estonie, au Brésil et en Ukraine.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
100 % à distance, partout dans le monde

Services

  • Agentic AI Systems
  • AI-Native Software
  • AI Cloud Infrastructure
  • Consulting & Advisory
  • AI Training for Companies
  • AI Agents & Chatbots
  • Workflow Automation
  • RAG Pipelines
  • Performance Analytics
  • Web Development
  • Mobile Development
  • Desktop Development
  • Server Development
  • Embedded Firmware
  • Embedded Linux & SoC
  • Edge AI & TinyML
  • Wireless & Connectivity
  • Hardware Prototyping
  • IoT Solutions

Solutions

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portails

  • Portail client
  • Portail investisseurs
  • Portail partenaires

Entreprise

  • À propos
  • Notre équipe
  • Témoignages
  • Investissement
  • Blog
  • Actualités
  • Carrières
  • Implantations
  • Contact

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Initiatives

  • Startup Program
  • Academy
  • Olymp Hill

© 2026 WNC (WeNoCode). Tous droits réservés.

🇺🇦Soutenez l’Ukraine
Tous les services

Edge AI et TinyML

Votre produit voit, entend et décide tout seul.

Des réponses instantanées, pas de facture cloud, et des données qui ne quittent jamais l’appareil.

Quand un produit doit réagir à l’instant où quelque chose se produit, un aller-retour vers le cloud est trop lent, trop coûteux, et cesse de fonctionner dès que la connexion tombe. Nous mettons le modèle sur l’appareil lui-même — pour qu’il réponde en millisecondes, continue hors ligne, et que les données qu’il lit n’aient jamais à quitter les mains du client. Ce sont les modèles de nos AI Labs adaptés pour tenir sur un microcontrôleur, une Jetson ou le NPU de votre SoC.
Gérons ensemble Ouvrir Kanban
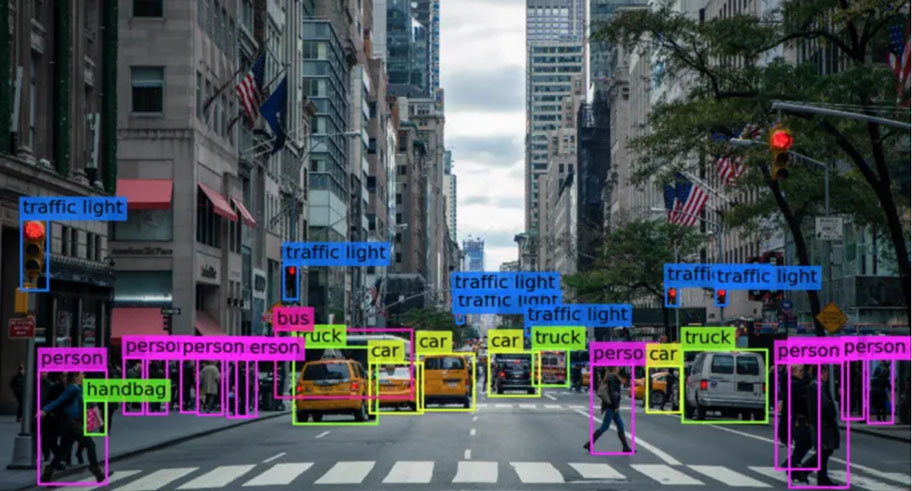
Vision par ordinateur exécutée sur un appareil edge

01 / Ce que ça résout

Des produits qui réagissent d’eux-mêmes.

01

Voir et agir en temps réel

Repérer, compter et suivre ce qui compte dans le flux caméra instantanément — d’un petit capteur Cortex-M à un rig Jetson multi-caméra.

02

Répondre à la voix, mains libres

Mots de réveil, commandes vocales et alertes sonores traités sur l’appareil, sans envoyer d’audio où que ce soit.

03

Repérer les problèmes avant qu’ils ne coûtent cher

Maintenance prédictive, reconnaissance de gestes et d’activité lues directement sur les capteurs embarqués.

04

Continue de s’améliorer après la sortie

Une seule boucle, des données à l’entraînement, aux évaluations sur l’appareil et aux mises à jour over-the-air, pour que le produit progresse sur le terrain.

02 / Stack

La technologie avec laquelle nous construisons.

Standard du secteur, ennuyeux dans le bon sens : des outils d’avenir, que le prochain ingénieur connaîtra aussi.

Runtimes d’inférence

  • TensorFlow Lite / LiteRT

    Modèles quantifiés sur MCU et SoC mobiles

  • ONNX Runtime

    Inférence portable sur CPU, GPU et NPU

  • TensorRT & DeepStream

    Pipelines de vision accélérés par GPU sur Jetson

  • Edge Impulse & TinyML

    Itération rapide de modèles pour cibles contraintes

Matériel cible

  • Cortex-M with CMSIS-NN

    Détection de mots-clés et d’anomalies en quelques kilo-octets

  • NVIDIA Jetson

    Vision multi-caméra en périphérie

  • Google Coral / Hailo

    Accélérateurs dédiés pour inférence basse consommation

  • Qualcomm & NXP NPUs

    Accélération sur le SoC dans les appareils en production

Pipeline de modèles

  • PyTorch

    Entraînement, distillation et export

  • Quantisation & pruning

    Modèles INT8 / INT4 qui conservent leur précision

  • Evals on-device

    Précision, latence et consommation mesurées sur la cible

  • OTA model delivery

    Modèles livrés et retournés comme du firmware

03 / Approche

Comment nous construisons des choses qui durent.

01

Mesuré sur la cible

Latence, mémoire et consommation de courant sont mesurées sur l’appareil réel, à chaque révision du modèle.

02

Milliwatts, pas watts

Inférence à cycle de service et accélérateurs choisis selon le budget de puissance réel du produit.

03

Privé par conception

Les données brutes restent sur l’appareil ; seul ce dont le produit a besoin en sort — si tant est que quelque chose en sorte.

04

Un seul pipeline, de l’appareil au cloud

Les données de la flotte alimentent l’entraînement ; un meilleur modèle revient comme une mise à jour ordinaire.

04 / Standards

Les bonnes pratiques que nous ne négligeons pas.

Nous respectons les standards du secteur et des méthodes éprouvées sur chaque projet — c’est ce qui fait tenir le devis.

  • Établir une base avec le modèle le plus simple qui pourrait fonctionner
  • Entraînement conscient de la quantification avant les astuces post-entraînement
  • Évaluations de précision sur de vraies captures de l’appareil, pas sur le jeu de labo
  • Budgets de latence et de puissance fixés comme critères d’acceptation
  • Comportement de repli défini pour les sorties à faible confiance
  • Versionnage des modèles et rollback via le canal OTA
  • Surveillance de la dérive à partir de la télémétrie de la flotte
  • Revue de confidentialité de chaque signal qui quitte l’appareil

05 / Infrastructure

Où ça tourne, et comment ça reste en ligne.

  • Bancs de benchmarking sur l’appareil (latence, mémoire, consommation)
  • Pipeline d’entraînement alimenté par les données de la flotte
  • Livraison de modèles par OTA avec rollback
  • Surveillance de la dérive et de la précision en production

Start

Vous voulez le modèle sur l’appareil ?

Dites-nous ce qu’il doit voir, entendre ou prédire — et sur quel matériel. Un ingénieur vous répond avec un périmètre et un prix honnêtes.

Let’s manage ou explorez AI Labs