WNC LogoWNC
LeistungenLösungenUnternehmenAcademyLabsKontakt
Kanban öffnen

We No Code. We Architect.

Projekt starten daniel@we-nocode.com
WNC LogoWNC

Partner für KI & Automatisierung. Mit Sorgfalt entwickelt in den USA, Polen, Estland, Brasilien & der Ukraine.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
Remote-first, weltweit

Lösungen

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portale

  • Kundenportal
  • Investorenportal
  • Partnerportal

Unternehmen

  • Über uns
  • Unser Team
  • Fallstudien
  • Referenzen
  • Investment
  • Blog
  • News
  • Karriere
  • Standorte
  • Kontakt

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Initiativen

  • Startup Program
  • Academy
  • Olymp Hill

Leistungen

Alle Leistungen
KI
  • Agentische KI-Systeme
  • KI-Agenten & Copilots
  • MCP-Server
  • RAG-Pipelines
  • Voice-KI-Agenten
  • KI-native Software
  • Workflow-Automatisierung
  • LLMOps & Evals
  • Fine-Tuning & Modelle
  • Dokumenten-KI
  • Computer Vision
Entwicklung
  • Web-Entwicklung
  • Mobile Entwicklung
  • SaaS- und MVP-Entwicklung
  • UI/UX- und Produktdesign
  • Integrationen & APIs
  • E-Commerce-Entwicklung
  • Legacy-Modernisierung
  • QA & Testautomatisierung
  • No-Code & Low-Code
  • Desktop-Entwicklung
Embedded & IoT
  • IoT-Lösungen
  • Embedded-Firmware
  • Embedded Linux & SoC
  • Edge AI & TinyML
  • Funk & Konnektivität
  • Hardware-Prototyping
  • IoT-Plattform & Cloud
  • Flotten- & OTA-Verwaltung
  • Industrielles IoT (IIoT)
  • IoT-Sicherheit
Cloud & Daten
  • Data Engineering
  • KI-Cloud-Infrastruktur
  • Server-Entwicklung
  • DevOps & Plattformen
  • Migration & FinOps
  • BI & Dashboards
  • Performance-Analytik
  • Support & SRE
Sicherheit
  • Pentests
  • KI-Red-Teaming
  • Compliance
  • Authentifizierung
  • Cloud-Sicherheit
  • Sichere Entwicklung
  • Supply-Chain-Sicherheit
  • Sicherheits-Audits
  • Security-Monitoring
  • Zero Trust
  • Datenschutz & DSGVO
Beratung
  • Beratung & Consulting
  • CTO-as-a-Service
  • KI-Strategie & Governance
  • Tech Due Diligence
  • Dedicated Team
  • KI-Schulungen für Unternehmen
F&E / Innovation
  • Proof of Concept & Machbarkeit
  • Rapid Prototyping
  • Angewandte KI-Forschung
  • Technologie-Scouting

© 2026 WNC. Alle Rechte vorbehalten.

🇺🇦Steht an der Seite der Ukraine

We No Code

Alle Leistungen

Fine-Tuning & eigene Modelle

Ein Modell, das Ihre Arbeit kennt – zu Ihren Bedingungen.

Offene und kleine Sprachmodelle, mit Evals trainiert und dort betrieben, wo Ihre Daten liegen.

Allzweckmodelle sind beeindruckend und teuer und manchmal schlicht unpassend: zu langsam, bei Volumen zu teuer, nicht in Ihrem Netz betreibbar oder unbeständig bei einer engen Aufgabe. Wir führen Fine-Tuning und Distillation offener und kleiner Modelle durch – Llama, Mistral, Qwen und andere – mit LoRA und QLoRA, belegen den Gewinn mit Evals gegen das Basismodell und betreiben sie privat. Und wenn Retrieval (RAG) die Aufgabe besser löst, sagen wir das zuerst.
Legen wir los Kanban öffnen
Fine-tuning and custom language models

01 / Was es löst

Kleiner, schneller, privat und messbar besser.

01

Auf Ihre Aufgabe trainiert

Einheitliches Format, Fachsprache und Verhalten bei den engen Aufgaben, die Sie tausendfach am Tag ausführen.

02

Läuft, wo Ihre Daten liegen

In Ihrer Cloud, auf eigenen GPUs oder Edge-Hardware – sensible Daten verlassen Ihre Umgebung nicht.

03

Weniger Kosten und Latenz

Ein kleines trainiertes Modell kann bei der richtigen Aufgabe ein großes ersetzen – zu einem Bruchteil der Kosten pro Anfrage.

04

Mit Evals belegt

Erfolgskriterien und zurückgehaltenes Testset stehen vor dem Training fest; das Modell geht nur live, wenn es gewinnt.

02 / Stack

Die Technologie, mit der wir bauen.

Branchenstandard, langweilig im besten Sinne: Werkzeuge mit Zukunft, die auch der nächste Entwickler kennt.

Offene Modelle

  • Llama

    Die offene Modellfamilie von Meta

  • Mistral

    Effiziente offene Modelle aus Europa

  • Qwen

    Starke mehrsprachige offene Modelle

  • Gemma

    Leichtgewichtige offene Modelle von Google

Training

  • LoRA / QLoRA

    Parametereffizientes Fine-Tuning

  • Distillation

    Ein kleines Modell von einem großen lernen lassen

  • Hugging Face

    Modell-Hub und Trainingsbibliotheken

  • PyTorch

    Deep-Learning-Framework

Betrieb

  • vLLM

    Model-Serving mit hohem Durchsatz

  • Ollama

    Lokale Laufzeit für Teams und Edge

  • NVIDIA GPUs

    GPU-Beschleunigung in Cloud und On-Premise

  • Quantisation

    Kleinere, schnellere Modelle für günstigere Hardware

03 / Vorgehen

Wie wir Dinge bauen, die bleiben.

01

RAG oder Fine-Tuning? Erst entscheiden

Wir prüfen, ob die Lücke Wissen, Verhalten oder Kosten betrifft, bevor wir überhaupt Training empfehlen.

02

Daten vor Training

Kuratierte, deduplizierte, datenschutzsichere Beispiele zählen mehr als Modellgröße; den Datensatz bauen wir mit Ihnen.

03

Eval-getriebene Iterationen

Jeder Trainingslauf wird auf Ihrem Testset mit dem Basismodell und einem starken gehosteten Modell verglichen.

04

Betrieb unter Ihrer Kontrolle

Quantisierte Modelle auf Ihrer Infrastruktur mit Monitoring, Versionierung und Rollback.

04 / Standards

Best Practices, die wir nicht auslassen.

Wir halten uns bei jedem Projekt an Branchenstandards und bewährte Methoden – sie sorgen dafür, dass der Kostenvoranschlag hält.

  • Zurückgehaltenes Testset vor dem Training festgelegt
  • Lizenzprüfung für jedes Basismodell
  • Personenbezogene Daten aus Trainingsdaten entfernt
  • Synthetische Daten geprüft, nie blind übernommen
  • Adapter zusammen mit Prompts versioniert
  • Quantisierung gegen Qualitätsverlust gemessen
  • Fallback auf ein gehostetes Modell bei geringer Sicherheit
  • Nachtraining bei Eval-Drift, nicht nach Kalender

05 / Infrastruktur

Wo es läuft und wie es am Laufen bleibt.

  • Trainingspipeline mit nachverfolgten Datensätzen und Läufen
  • LoRA-Adapter oder destillierte kleine Modelle
  • vLLM-Serving in Ihrer Cloud, On-Premise oder auf Edge-GPUs
  • Eval-Suite und Monitoring für das betriebene Modell

Gute Fragen

Was Kunden uns fragen

Klare Antworten auf das, was Kunden vor dem Start wissen wollen.

Oft nicht. Fehlt Wissen, ist Retrieval (RAG) meist günstiger und leichter aktuell zu halten. Fine-Tuning lohnt sich für ein einheitliches Format oder einen einheitlichen Stil, eine enge, wiederkehrende Aufgabe, geringere Latenz oder Kosten durch ein kleineres Modell oder den Betrieb vollständig auf eigener Infrastruktur. WNC sagt Ihnen, was zutrifft, bevor irgendetwas trainiert wird.

Verwandte Arbeiten

Wo wir das schon gemacht haben

Projekte und eigene Produkte, in denen dieser Service steckt.

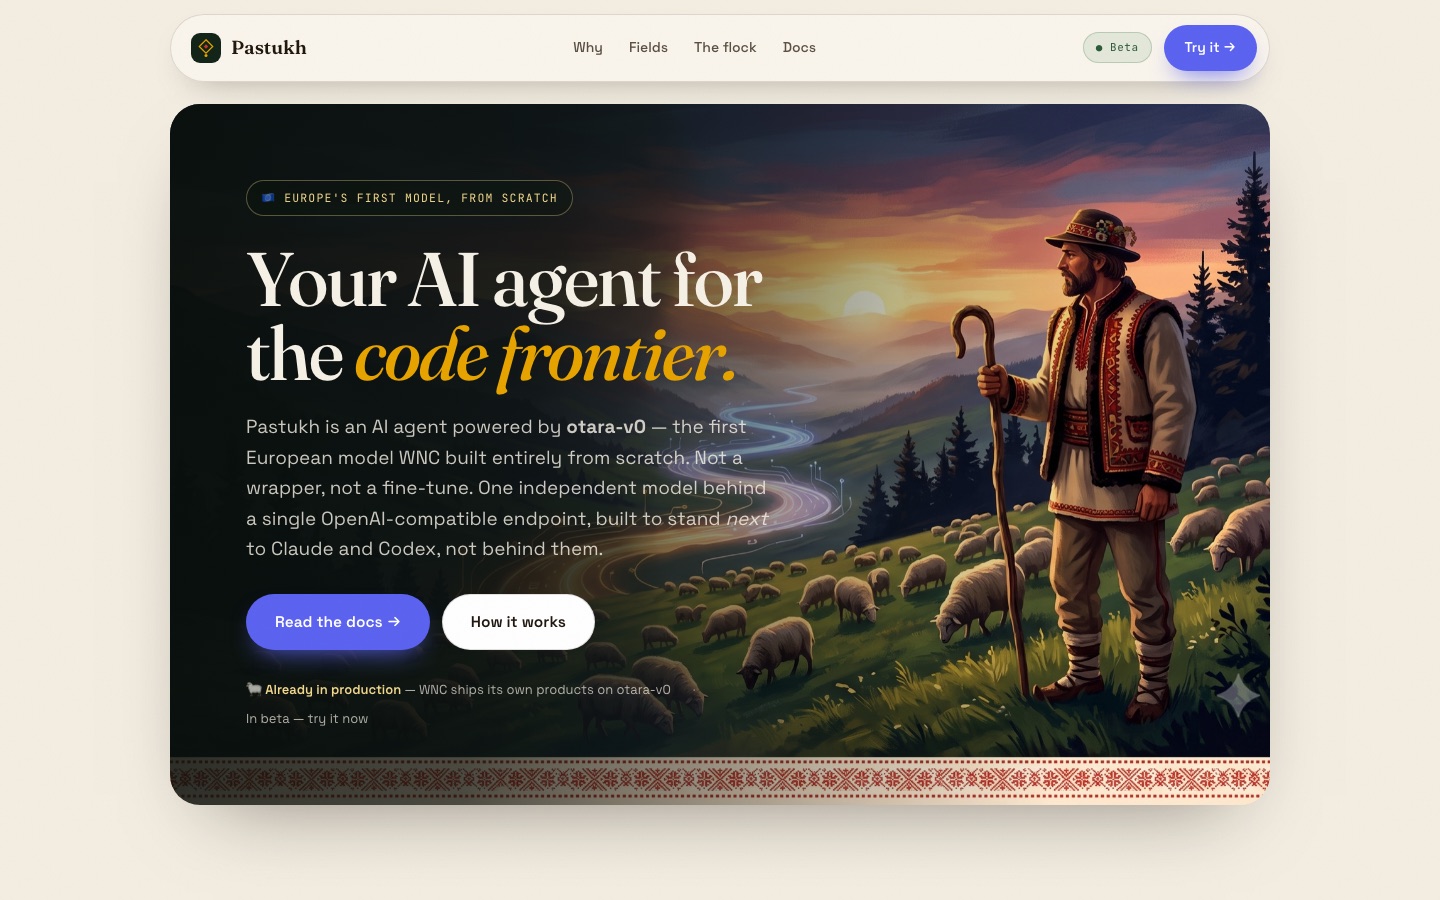
Pastukh
Unser Produkt

Pastukh

Ein KI-Coding-Agent auf Basis von otara-v0, einem Modell, das WNC von Grund auf gebaut hat – kein Wrapper, kein Fine-Tune – hinter einem OpenAI-kompatiblen Endpunkt. In der Beta.

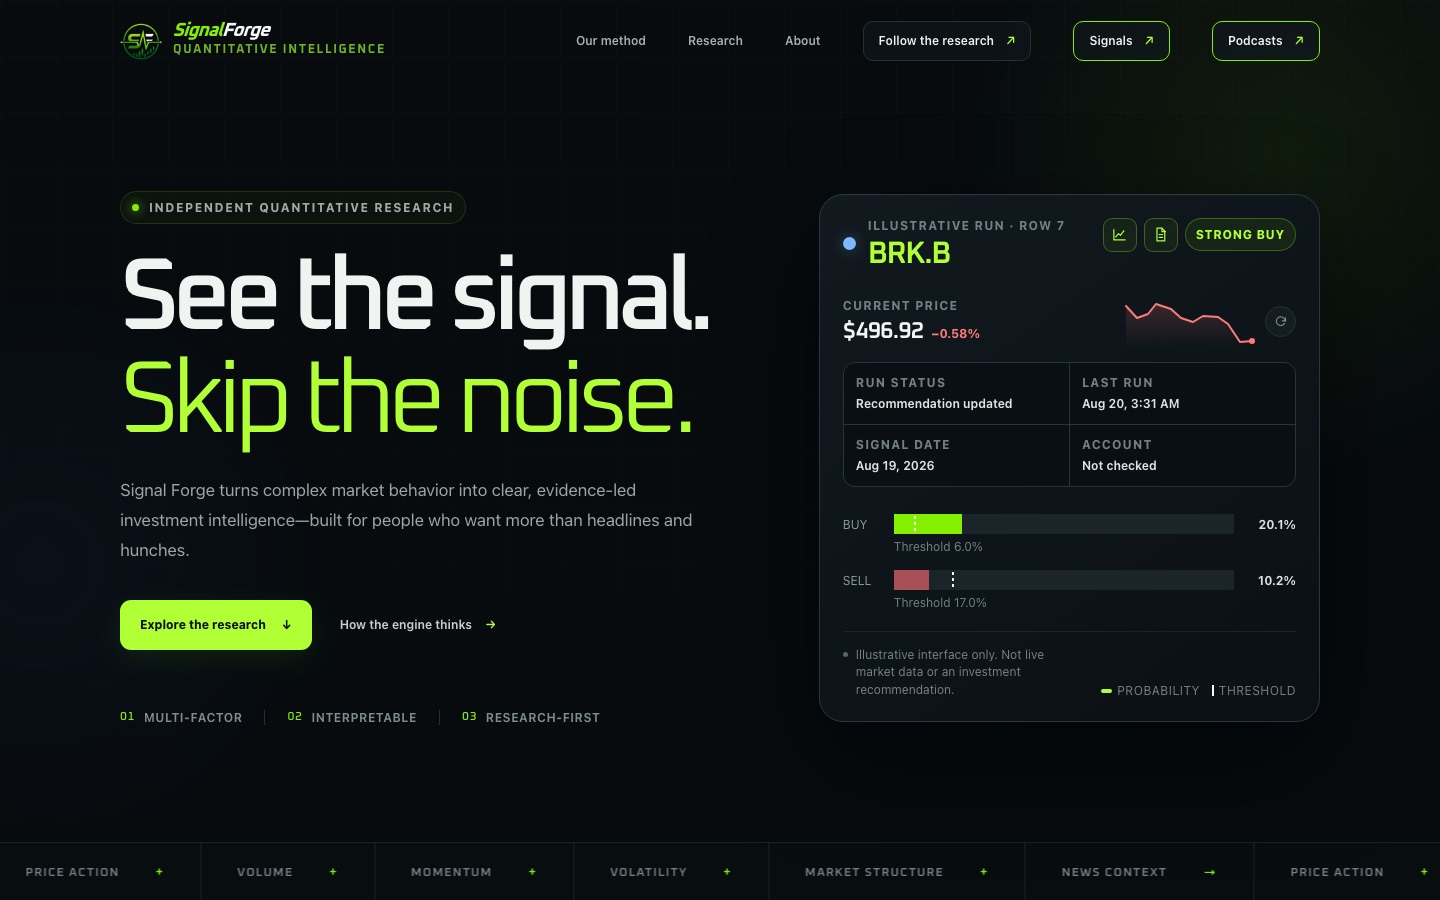
Signal Forge
KI · Quantitative Finanzen

Signal Forge

Quantitative Intelligence für klügeres Investieren: eine Engine, die komplexes Marktverhalten in klare, evidenzbasierte Buy-, Hold- oder Sell-Signale verwandelt – gebaut mit Alexander Grover, früher als TickerPulse.

Start

Bereit für ein Modell, das zu Ihrer Aufgabe passt?

Erzählen Sie uns, was das Modell können und wo es laufen soll. Ein Senior Engineer antwortet mit ehrlichem Umfang und Preis.

Let’s manage RAG-Pipelines ansehen