WNC LogoWNC
LeistungenLösungenUnternehmenAcademyLabsKontakt
Kanban öffnen

We No Code. We Architect.

Projekt starten daniel@we-nocode.com
WNC LogoWNC

Partner für KI & Automatisierung. Mit Sorgfalt entwickelt in den USA, Polen, Estland, Brasilien & der Ukraine.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
Remote-first, weltweit

Lösungen

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portale

  • Kundenportal
  • Investorenportal
  • Partnerportal

Unternehmen

  • Über uns
  • Unser Team
  • Fallstudien
  • Referenzen
  • Investment
  • Blog
  • News
  • Karriere
  • Standorte
  • Kontakt

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Initiativen

  • Startup Program
  • Academy
  • Olymp Hill

Leistungen

Alle Leistungen
KI
  • Agentische KI-Systeme
  • KI-Agenten & Copilots
  • MCP-Server
  • RAG-Pipelines
  • Voice-KI-Agenten
  • KI-native Software
  • Workflow-Automatisierung
  • LLMOps & Evals
  • Fine-Tuning & Modelle
  • Dokumenten-KI
  • Computer Vision
Entwicklung
  • Web-Entwicklung
  • Mobile Entwicklung
  • SaaS- und MVP-Entwicklung
  • UI/UX- und Produktdesign
  • Integrationen & APIs
  • E-Commerce-Entwicklung
  • Legacy-Modernisierung
  • QA & Testautomatisierung
  • No-Code & Low-Code
  • Desktop-Entwicklung
Embedded & IoT
  • IoT-Lösungen
  • Embedded-Firmware
  • Embedded Linux & SoC
  • Edge AI & TinyML
  • Funk & Konnektivität
  • Hardware-Prototyping
  • IoT-Plattform & Cloud
  • Flotten- & OTA-Verwaltung
  • Industrielles IoT (IIoT)
  • IoT-Sicherheit
Cloud & Daten
  • Data Engineering
  • KI-Cloud-Infrastruktur
  • Server-Entwicklung
  • DevOps & Plattformen
  • Migration & FinOps
  • BI & Dashboards
  • Performance-Analytik
  • Support & SRE
Sicherheit
  • Pentests
  • KI-Red-Teaming
  • Compliance
  • Authentifizierung
  • Cloud-Sicherheit
  • Sichere Entwicklung
  • Supply-Chain-Sicherheit
  • Sicherheits-Audits
  • Security-Monitoring
  • Zero Trust
  • Datenschutz & DSGVO
Beratung
  • Beratung & Consulting
  • CTO-as-a-Service
  • KI-Strategie & Governance
  • Tech Due Diligence
  • Dedicated Team
  • KI-Schulungen für Unternehmen
F&E / Innovation
  • Proof of Concept & Machbarkeit
  • Rapid Prototyping
  • Angewandte KI-Forschung
  • Technologie-Scouting

© 2026 WNC. Alle Rechte vorbehalten.

🇺🇦Steht an der Seite der Ukraine

We No Code

Alle Leistungen

Edge AI und TinyML

Ihr Produkt sieht, hört und entscheidet von selbst.

Sofortige Reaktionen, keine Cloud-Rechnung und Daten, die das Gerät nie verlassen.

Wenn ein Produkt in dem Moment reagieren muss, in dem etwas passiert, ist der Umweg in die Cloud zu langsam, zu teuer und bricht ab, sobald die Verbindung abreißt. Wir bringen das Modell auf das Gerät selbst, damit es in Millisekunden reagiert, offline weiterläuft und die Daten, die es liest, nie die Hand des Kunden verlassen müssen. Es sind die Modelle aus unseren AI Labs, passend gemacht für einen Mikrocontroller, eine Jetson oder die NPU Ihres SoC.
Legen wir los Kanban öffnen
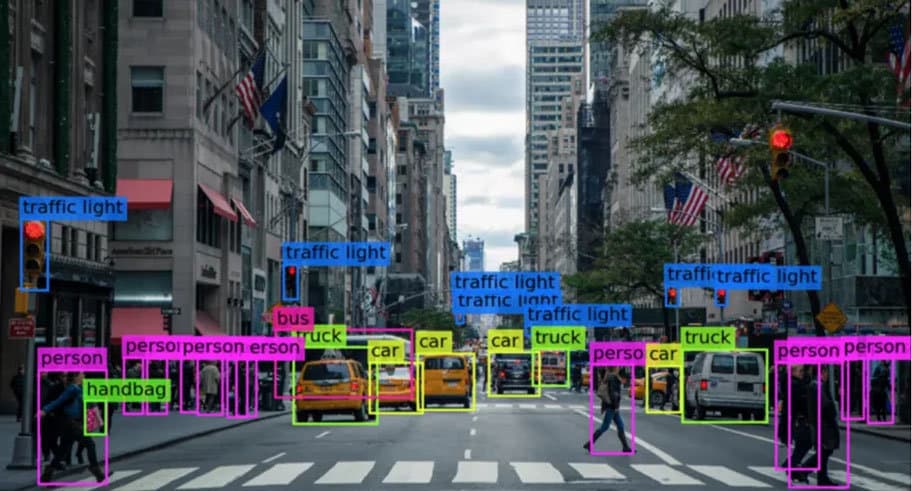
Computer Vision, ausgeführt auf einem Edge-Gerät

01 / Was es löst

Produkte, die von selbst reagieren.

01

In Echtzeit sehen und handeln

Erkennen, zählen und verfolgen, was im Kamerabild zählt – sofort, von einem winzigen Cortex-M-Sensor bis zu einem Multi-Kamera-Jetson-Rig.

02

Freihändig auf Sprache reagieren

Weckwörter, Sprachbefehle und Tonwarnungen werden auf dem Gerät verarbeitet, ohne dass Audio irgendwohin gesendet wird.

03

Probleme erkennen, bevor sie Geld kosten

Vorausschauende Wartung, Gesten- und Aktivitätserkennung direkt aus den Sensoren an Bord gelesen.

04

Wird nach dem Marktstart immer besser

Eine einzige Schleife von Daten über Training bis zu On-Device-Evaluierungen und Over-the-Air-Updates, damit sich das Produkt im Feld verbessert.

02 / Stack

Die Technologie, mit der wir bauen.

Branchenstandard, langweilig im besten Sinne: Werkzeuge mit Zukunft, die auch der nächste Entwickler kennt.

Inferenz-Runtimes

  • TensorFlow Lite / LiteRT

    Quantisierte Modelle auf MCUs und mobilen SoCs

  • ONNX Runtime

    Portable Inferenz über CPUs, GPUs und NPUs hinweg

  • TensorRT & DeepStream

    GPU-beschleunigte Vision-Pipelines auf Jetson

  • Edge Impulse & TinyML

    Schnelle Modell-Iteration für ressourcenbeschränkte Ziele

Zielhardware

  • Cortex-M with CMSIS-NN

    Keyword-Spotting und Anomalieerkennung in wenigen Kilobyte

  • NVIDIA Jetson

    Multi-Kamera-Vision am Edge

  • Google Coral / Hailo

    Dedizierte Beschleuniger für stromsparende Inferenz

  • Qualcomm & NXP NPUs

    Beschleunigung direkt auf dem SoC in Produktionsgeräten

Modell-Pipeline

  • PyTorch

    Training, Distillation und Export

  • Quantisation & pruning

    INT8-/INT4-Modelle, die ihre Genauigkeit behalten

  • Evals on-device

    Genauigkeit, Latenz und Stromverbrauch auf dem Zielgerät gemessen

  • OTA model delivery

    Modelle werden ausgeliefert und wie Firmware zurückgerollt

03 / Vorgehen

Wie wir Dinge bauen, die bleiben.

01

Auf dem Zielgerät gemessen

Latenz, Speicher und Stromaufnahme werden bei jeder Modellrevision auf dem echten Gerät gemessen.

02

Milliwatt, nicht Watt

Duty-cycled Inferenz und Beschleuniger, gewählt nach dem tatsächlichen Energiebudget des Produkts.

03

Privat by Design

Rohdaten bleiben auf dem Gerät; nur das, was das Produkt braucht, verlässt es, wenn überhaupt etwas.

04

Eine Pipeline, vom Gerät bis zur Cloud

Daten aus der Flotte fließen ins Training; ein besseres Modell kommt als gewöhnliches Update zurück.

04 / Standards

Best Practices, die wir nicht auslassen.

Wir halten uns bei jedem Projekt an Branchenstandards und bewährte Methoden – sie sorgen dafür, dass der Kostenvoranschlag hält.

  • Mit dem kleinsten Modell beginnen, das funktionieren kann – destillierte oder quantisierte kleine Modelle vor großen
  • Quantisierungsbewusstes Training vor Post-Training-Tricks
  • Genauigkeitsevaluierungen auf echten Geräteaufnahmen, nicht auf dem Labor-Datensatz
  • Latenz- und Energiebudgets als feste Abnahmekriterien
  • Fallback-Verhalten für Ausgaben mit geringer Konfidenz definiert
  • Modellversionierung und Rollback über den OTA-Kanal
  • Drift-Monitoring aus der Flottentelemetrie, Nachtraining über den OTA-Kanal
  • Datenschutzprüfung jedes Signals, das das Gerät verlässt

05 / Infrastruktur

Wo es läuft und wie es am Laufen bleibt.

  • On-Device-Benchmarking-Aufbauten (Latenz, Speicher, Stromverbrauch)
  • Trainingspipeline, gespeist aus Flottendaten
  • OTA-Modellauslieferung mit Rollback
  • Drift- und Genauigkeitsüberwachung im Produktivbetrieb

Gute Fragen

Was Kunden uns fragen

Klare Antworten auf das, was Kunden vor dem Start wissen wollen.

Ja, wenn die Hardware es zulässt. WNC beginnt mit dem kleinsten Modell, das die Aufgabe löst: destilliert oder quantisiert –, und setzt es auf NVIDIA Jetson und ähnlichen NPUs ein, mit Latenz- und Energiebudgets als Abnahmekriterien.

Verwandte Arbeiten

Wo wir das schon gemacht haben

Projekte und eigene Produkte, in denen dieser Service steckt.

Hirske Dzherelo
IoT · Fertigung

Hirske Dzherelo

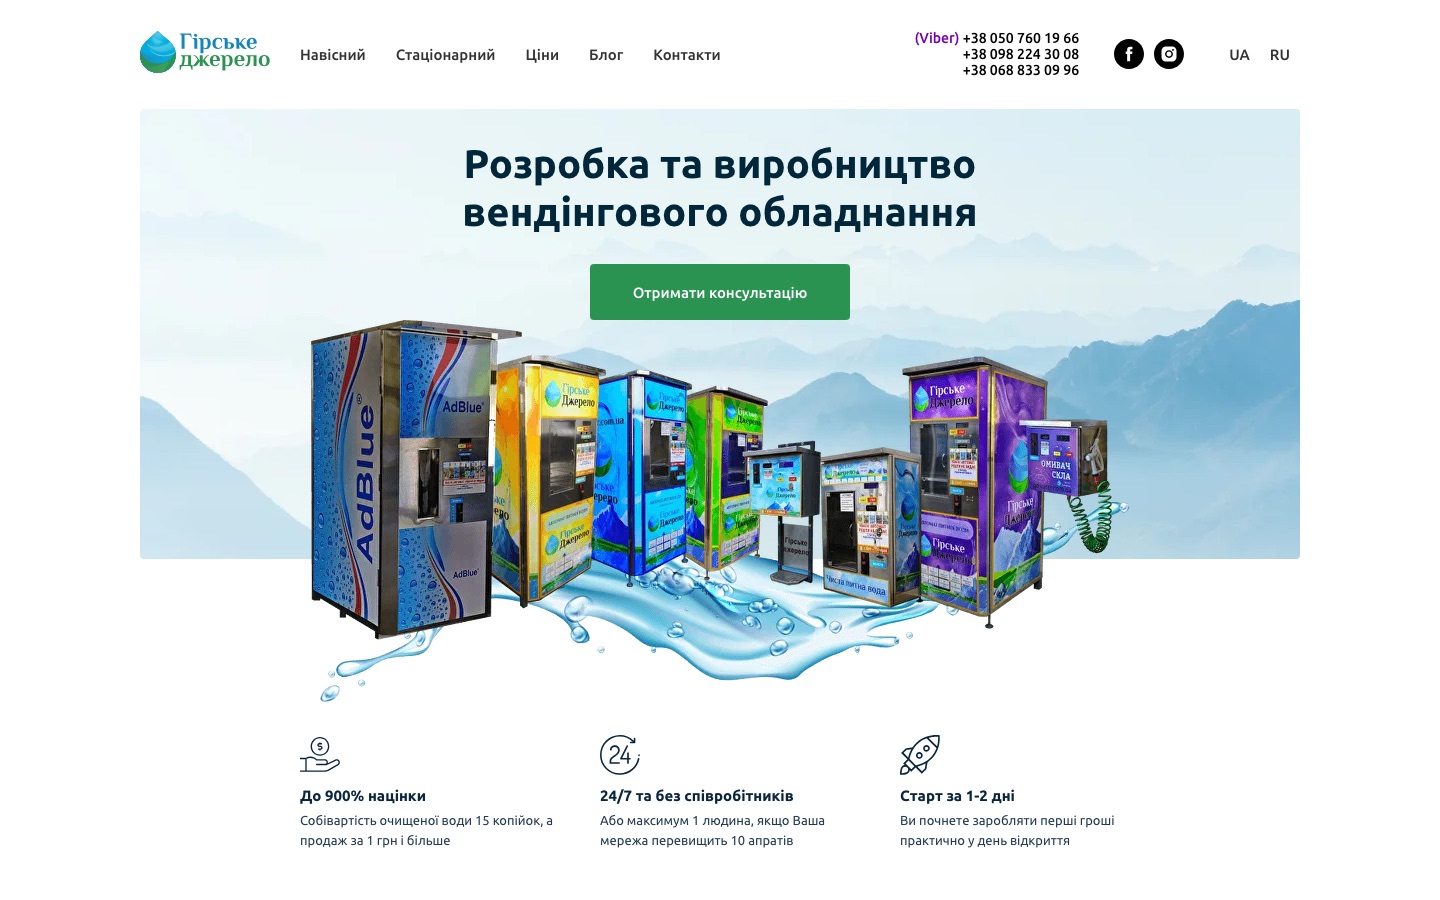
IoT für eine Fabrik, die Trinkwasserautomaten baut: Jeder Automat meldet sich alle 3–5 Sekunden beim Server und wird aus einem Web-Kabinett und einem Telegram-Bot aus der Ferne überwacht und eingestellt.

IoT · TelekommunikationIoT-Service-Intelligence-Plattform für Mobilfunkbetreiber
IoT · Telekommunikation

IoT-Service-Intelligence-Plattform für Mobilfunkbetreiber

Von Konnektivität zu Intelligenz: eine Plattform über den bestehenden Systemen eines Betreibers, die verstreute SIM-, Geräte-, Traffic- und Servicedaten in Sichtbarkeit, Vertrauen und Handlung für Geschäftskunden verwandelt.

Start

Wollen Sie das Modell auf dem Gerät?

Sagen Sie uns, was es sehen, hören oder vorhersagen muss und auf welcher Hardware. Ein Ingenieur antwortet mit einem ehrlichen Umfang und Preis.

Let’s manage oder AI Labs entdecken