WNC LogoWNC
LeistungenLösungenUnternehmenAcademyLabsKontakt
Kanban öffnen

We No Code. We Architect.

Projekt starten daniel@we-nocode.com
WNC LogoWNC

Partner für KI & Automatisierung. Mit Sorgfalt entwickelt in den USA, Polen, Estland, Brasilien & der Ukraine.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
Remote-first, weltweit

Lösungen

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portale

  • Kundenportal
  • Investorenportal
  • Partnerportal

Unternehmen

  • Über uns
  • Unser Team
  • Fallstudien
  • Referenzen
  • Investment
  • Blog
  • News
  • Karriere
  • Standorte
  • Kontakt

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Initiativen

  • Startup Program
  • Academy
  • Olymp Hill

Leistungen

Alle Leistungen
KI
  • Agentische KI-Systeme
  • KI-Agenten & Copilots
  • MCP-Server
  • RAG-Pipelines
  • Voice-KI-Agenten
  • KI-native Software
  • Workflow-Automatisierung
  • LLMOps & Evals
  • Fine-Tuning & Modelle
  • Dokumenten-KI
  • Computer Vision
Entwicklung
  • Web-Entwicklung
  • Mobile Entwicklung
  • SaaS- und MVP-Entwicklung
  • UI/UX- und Produktdesign
  • Integrationen & APIs
  • E-Commerce-Entwicklung
  • Legacy-Modernisierung
  • QA & Testautomatisierung
  • No-Code & Low-Code
  • Desktop-Entwicklung
Embedded & IoT
  • IoT-Lösungen
  • Embedded-Firmware
  • Embedded Linux & SoC
  • Edge AI & TinyML
  • Funk & Konnektivität
  • Hardware-Prototyping
  • IoT-Plattform & Cloud
  • Flotten- & OTA-Verwaltung
  • Industrielles IoT (IIoT)
  • IoT-Sicherheit
Cloud & Daten
  • Data Engineering
  • KI-Cloud-Infrastruktur
  • Server-Entwicklung
  • DevOps & Plattformen
  • Migration & FinOps
  • BI & Dashboards
  • Performance-Analytik
  • Support & SRE
Sicherheit
  • Pentests
  • KI-Red-Teaming
  • Compliance
  • Authentifizierung
  • Cloud-Sicherheit
  • Sichere Entwicklung
  • Supply-Chain-Sicherheit
  • Sicherheits-Audits
  • Security-Monitoring
  • Zero Trust
  • Datenschutz & DSGVO
Beratung
  • Beratung & Consulting
  • CTO-as-a-Service
  • KI-Strategie & Governance
  • Tech Due Diligence
  • Dedicated Team
  • KI-Schulungen für Unternehmen
F&E / Innovation
  • Proof of Concept & Machbarkeit
  • Rapid Prototyping
  • Angewandte KI-Forschung
  • Technologie-Scouting

© 2026 WNC. Alle Rechte vorbehalten.

🇺🇦Steht an der Seite der Ukraine

We No Code

Alle Leistungen

LLMOps, Evals & Guardrails

KI-Funktionen, die Sie messen und denen Sie vertrauen.

Evals, Tracing, Guardrails und Kostenkontrolle, die Betriebsebene für LLM-Anwendungen.

Eine KI-Funktion zu starten ist der leichte Teil; sie genau, sicher und bezahlbar zu halten, während sich Prompts, Modelle und Daten ändern, ist die Arbeit. Wir bauen die Betriebsebene rund um Ihre LLM-Anwendungen: Eval-Suites und LLM-as-a-Judge, die jedes Release bewerten, Tracing, das zeigt, was das Modell gesehen und getan hat, Guardrails gegen unsichere Ein- und Ausgaben sowie Kosten- und Latenzkontrolle mit Modell-Routing, damit Qualität gemessen statt angenommen wird.
Legen wir los Kanban öffnen
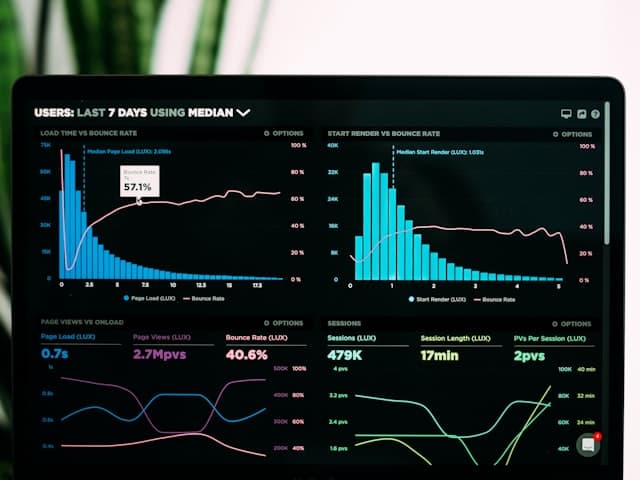
LLMOps dashboards: evals, traces and costs of AI features

01 / Was es löst

Von „in der Demo sah es gut aus“ zu gemessener Qualität.

01

Evals bei jedem Release

Referenzdatensätze und Judges bewerten Genauigkeit, Quellentreue, Ton und Richtlinien, damit ein Prompt- oder Modellwechsel nicht unbemerkt verschlechtert.

02

Jeden Schritt sehen

Traces von Prompts, Retrieval, Tool-Aufrufen und Antworten, verknüpft mit Nutzern und Versionen, für schnelles Debugging.

03

Guardrails, die halten

Prüfungen auf Prompt Injection, Datenabfluss, Themenabweichung und unsichere Inhalte – bei Ein- und Ausgabe.

04

Kosten und Latenz im Griff

Kosten pro Anfrage und Funktion, Caching und Routing zu kleineren Modellen, wo die Qualität es erlaubt.

02 / Stack

Die Technologie, mit der wir bauen.

Branchenstandard, langweilig im besten Sinne: Werkzeuge mit Zukunft, die auch der nächste Entwickler kennt.

Tracing & Observability

  • Langfuse

    Open-Source-Tracing und -Analysen für LLMs

  • OpenTelemetry

    Herstellerneutraler Telemetrie-Standard

  • MLflow

    Experiment-Tracking und Evaluation

  • Arize Phoenix

    Open-Source-LLM-Observability

Evaluation

  • LLM-as-a-judge

    Modellbasierte Bewertung nach klaren Kriterien

  • Golden datasets

    Testsets aus echtem Traffic

  • Promptfoo

    Prompt- und Regressionstests in der CI

  • Ragas

    Metriken für Retrieval- und RAG-Qualität

Guardrails & Steuerung

  • Guardrail models

    Sicherheitsprüfungen für Ein- und Ausgabe

  • LLM gateway

    Ein Einstiegspunkt für Routing, Limits und Schlüssel

  • Prompt registry

    Versionierte Prompts mit Rollback

  • Semantic caching

    Antworten auf wiederkehrende Fragen wiederverwenden

03 / Vorgehen

Wie wir Dinge bauen, die bleiben.

01

Zuerst Qualität definieren

Wir legen mit Ihnen fest, was eine gute Antwort ist, und machen daraus Kriterien und Testfälle, bevor wir etwas tunen.

02

Evals in der CI

Jede Änderung an Prompts, Modellen oder Daten startet die Suite; Regressionen blockieren das Release wie ein fehlgeschlagener Test.

03

Das richtige Modell pro Aufgabe

Routing schickt Einfaches an kleine, günstige Modelle und Schwieriges an die stärksten, mit Fallbacks.

04

Alarme bei Drift

Bewertung einer Stichprobe des Live-Traffics und Alarme, wenn sich Qualität, Kosten oder Latenz verschieben.

04 / Standards

Best Practices, die wir nicht auslassen.

Wir halten uns bei jedem Projekt an Branchenstandards und bewährte Methoden – sie sorgen dafür, dass der Kostenvoranschlag hält.

  • Referenzdatensätze aus echtem Nutzer-Traffic
  • Mit menschlichen Labels kalibrierte Judges
  • Prompt- und Modellversion in jedem Trace
  • Schwärzung personenbezogener Daten in Logs und Traces
  • Tests auf Prompt Injection und Datenabfluss
  • Budgets und Limits pro Funktion
  • Fallback-Modelle bei Ausfällen
  • Menschliche Prüfung unsicherer Antworten

05 / Infrastruktur

Wo es läuft und wie es am Laufen bleibt.

  • Tracing jedes LLM- und Tool-Aufrufs
  • Eval-Suite in der CI und auf Stichproben aus Produktion
  • LLM-Gateway mit Routing, Cache und Budgets
  • Dashboards und Alarme für Qualität, Kosten und Latenz

Gute Fragen

Was Kunden uns fragen

Klare Antworten auf das, was Kunden vor dem Start wissen wollen.

Weil sich ihr Verhalten ändert, wenn ihr einen Prompt anpasst, das Modell wechselt oder die Daten aktualisiert und eine normale Testsuite das nicht bemerkt. Evals machen aus „scheint zu passen“ gemessene Qualität: Genauigkeit, Quellentreue, Tonalität, Richtlinien –, geprüft vor jedem Release.

Verwandte Arbeiten

Wo wir das schon gemacht haben

Projekte und eigene Produkte, in denen dieser Service steckt.

Pastukh
Unser Produkt

Pastukh

Ein KI-Coding-Agent auf Basis von otara-v0, einem Modell, das WNC von Grund auf gebaut hat – kein Wrapper, kein Fine-Tune – hinter einem OpenAI-kompatiblen Endpunkt. In der Beta.

AdCrier
Unser Produkt

AdCrier

Gesponserte Antworten, bezahlt pro Klick: ein zweiseitiger Marktplatz, der KI-Apps, die monetarisieren wollen, mit Werbetreibenden verbindet, die ihre Nutzer erreichen wollen: direktes CPC-Bieten, Kategorie-Targeting, keine Drittnetzwerke.

KI-Support-Agent + Dashboard für einen Autohersteller
KI-Agenten · Kundenservice

KI-Support-Agent + Dashboard für einen Autohersteller

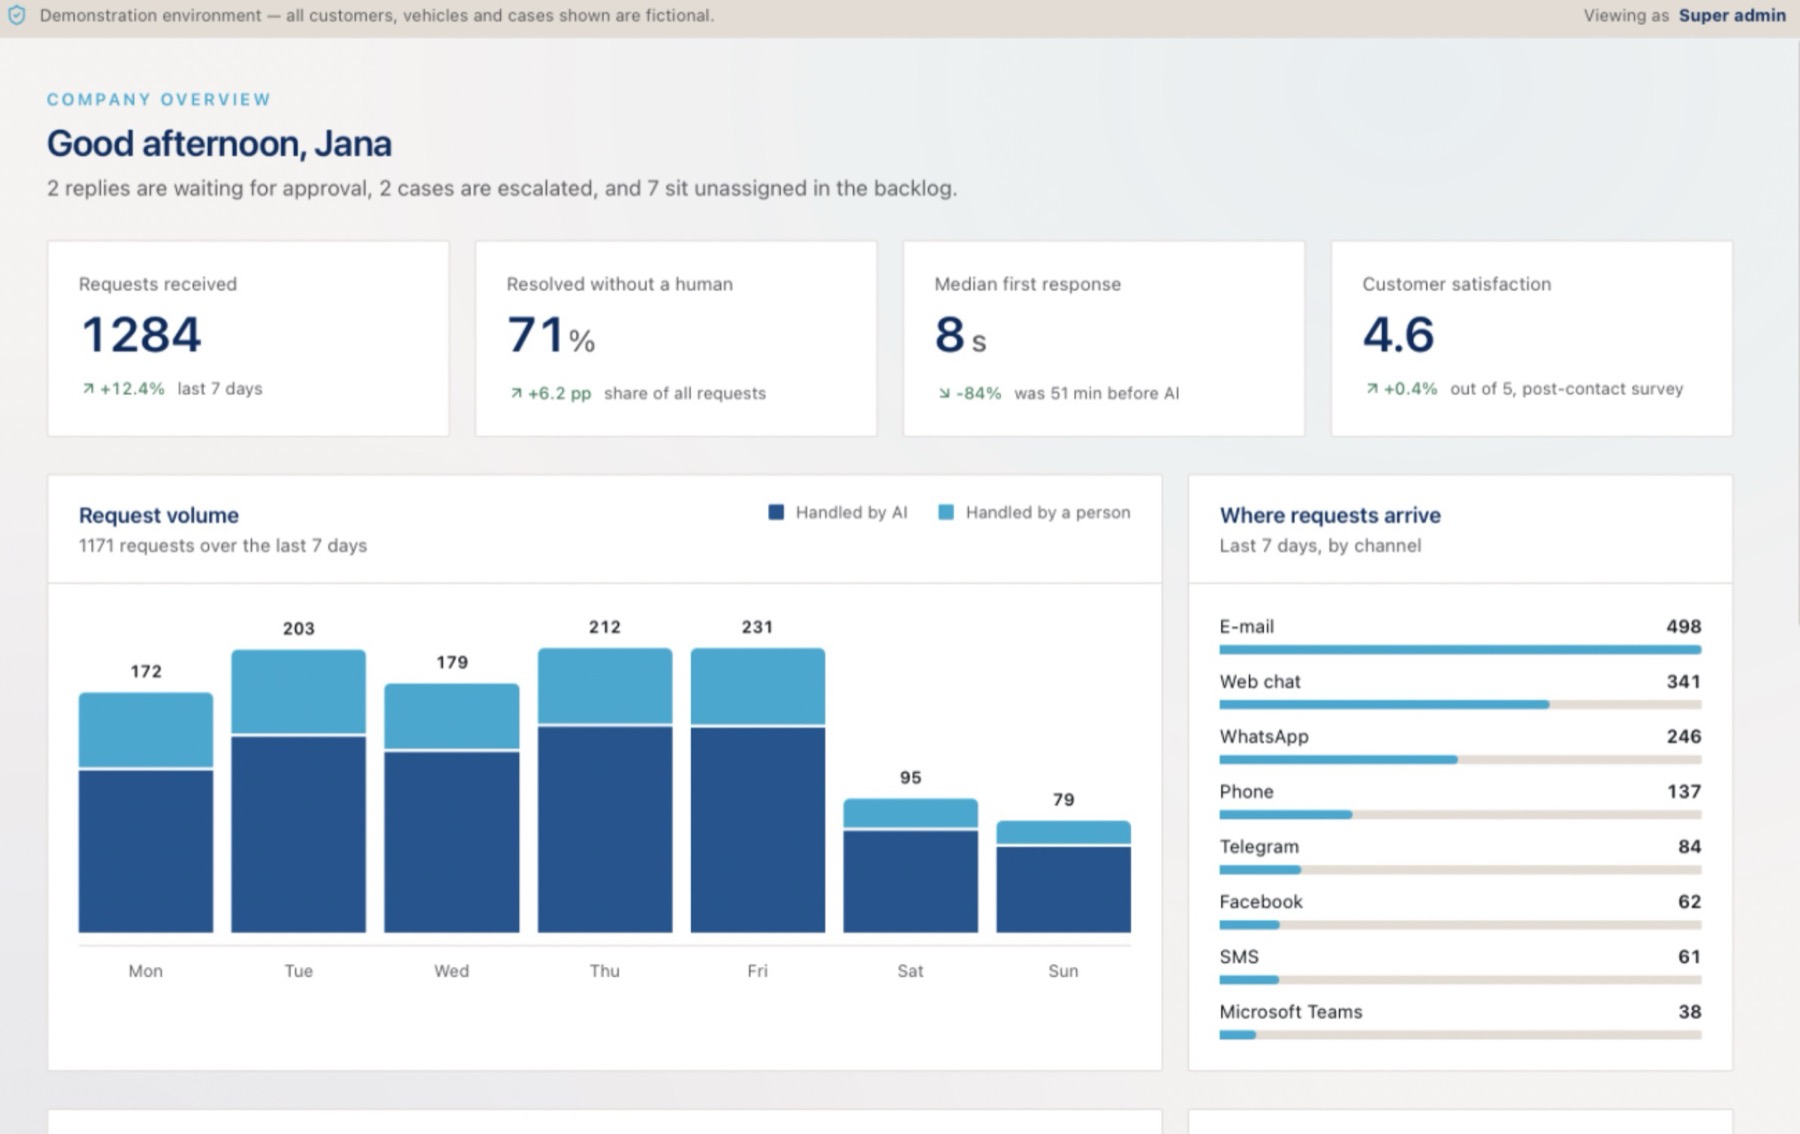
Jede Kundenanfrage wird von der KI gelesen und klassifiziert, der Fahrzeugdatensatz automatisch geladen und eine Antwort entworfen und nichts erreicht den Kunden, bevor ein Agent sie freigibt.

Start

Bereit zu wissen, wie gut Ihre KI wirklich ist?

Erzählen Sie uns, welche KI-Funktionen Sie betreiben. Ein Senior Engineer antwortet mit ehrlichem Umfang und Preis.

Let’s manage Performance-Analytics ansehen