LLMOps, evale i guardrails
Evale, śledzenie, guardrails i kontrola kosztów – warstwa operacyjna dla aplikacji LLM.
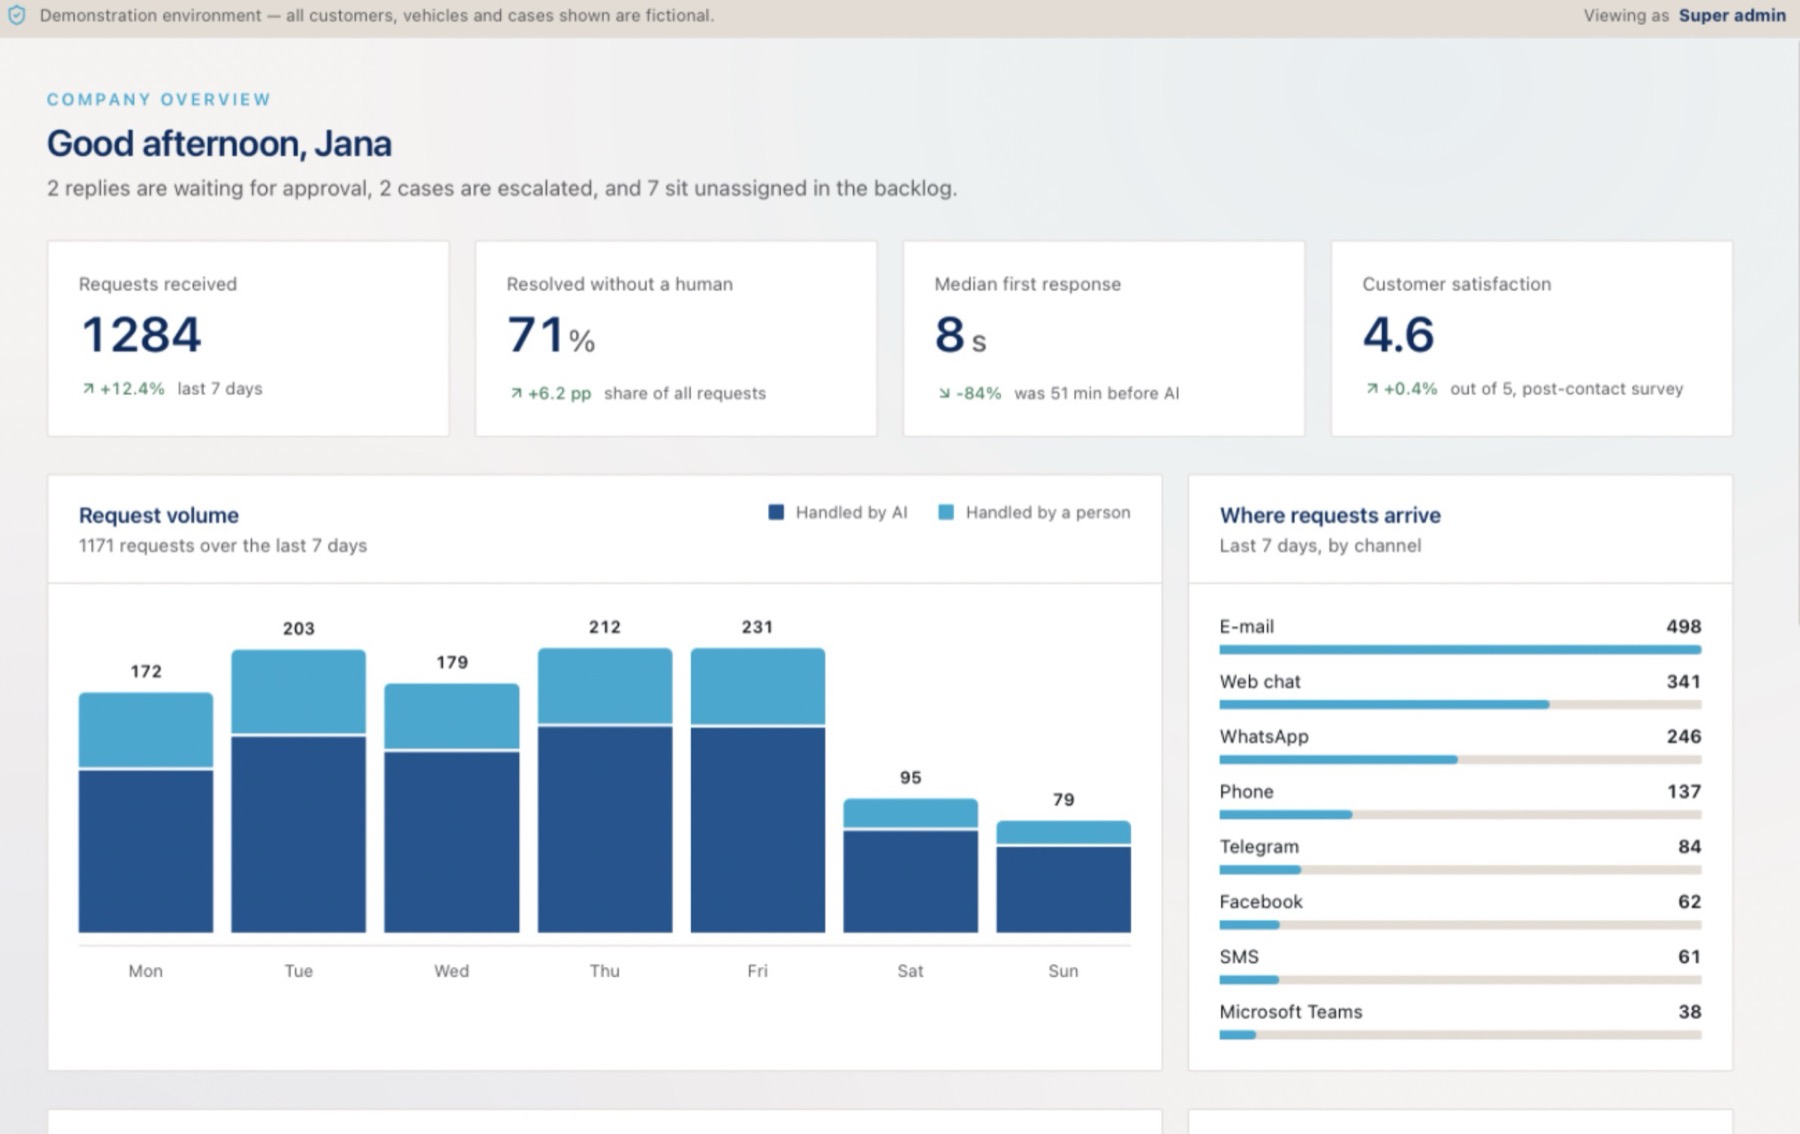
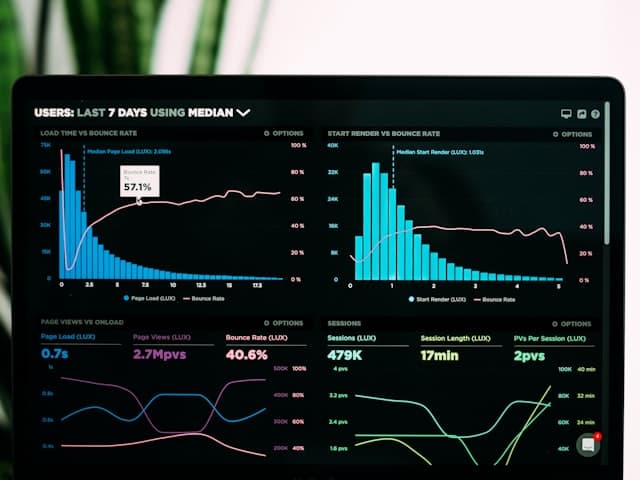
Uruchomić funkcję AI to łatwa część; utrzymać ją trafną, bezpieczną i tanią, gdy zmieniają się prompty, modele i dane – to właściwa praca. Budujemy warstwę operacyjną wokół waszych aplikacji LLM: zestawy evali i LLM-as-a-judge oceniające każde wydanie, śledzenie pokazujące, co model widział i zrobił, guardrails wyłapujące niebezpieczne wejścia i wyjścia oraz kontrolę kosztów i opóźnień z routingiem modeli, żeby jakość była mierzona, a nie zakładana.
01 / Co to rozwiązuje
Zbiory wzorcowe i sędziowie oceniający trafność, oparcie w źródłach, ton i zasady, żeby zmiana promptu czy modelu nie pogorszyła niczego po cichu.
Ślady promptów, wyszukiwań, wywołań narzędzi i odpowiedzi, powiązane z użytkownikami i wersjami, do szybkiego debugowania.
Kontrole prompt injection, wycieku danych, zbaczania z tematu i niebezpiecznych treści na wejściu i wyjściu.
Koszt na zapytanie i funkcję, cache i routing do mniejszych modeli tam, gdzie jakość na to pozwala.
02 / Stos
Standardy branżowe, nudne w dobrym sensie: narzędzia z przyszłością, które będzie znał także następny inżynier.
Śledzenie i obserwowalność
Langfuse
Otwarte śledzenie i analityka LLM
OpenTelemetry
Neutralny standard telemetrii
MLflow
Śledzenie eksperymentów i ewaluacja
Arize Phoenix
Otwarta obserwowalność LLM
Ewaluacja
LLM-as-a-judge
Ocena modelem według jasnych kryteriów
Golden datasets
Zbiory testowe z prawdziwego ruchu
Promptfoo
Testy promptów i regresji w CI
Ragas
Metryki jakości wyszukiwania i RAG
Guardrails i kontrola
Guardrail models
Kontrole bezpieczeństwa wejścia i wyjścia
LLM gateway
Jeden punkt wejścia dla routingu, limitów i kluczy
Prompt registry
Wersjonowane prompty z możliwością wycofania
Semantic caching
Ponowne użycie odpowiedzi na powtarzalne pytania
03 / Podejście
Ustalamy z wami, czym jest dobra odpowiedź, i zamieniamy to w kryteria i przypadki testowe, zanim cokolwiek stroimy.
Każda zmiana promptów, modeli lub danych uruchamia zestaw; regresja blokuje wydanie jak nieprzechodzący test.
Routing kieruje proste zapytania do małych, tanich modeli, a trudne do najmocniejszych, z modelami zapasowymi.
Ocena próbki ruchu produkcyjnego i alerty, gdy zmienia się jakość, koszt lub opóźnienie.
04 / Standardy
Trzymamy się standardów branżowych i sprawdzonych metod w każdym projekcie – to właśnie dzięki nim wycena pozostaje realistyczna.
05 / Infrastruktura
Dobre pytania
Konkretne odpowiedzi na pytania klientów przed startem.
Bo ich zachowanie zmienia się, gdy edytujecie prompt, zmieniacie model lub aktualizujecie dane, a zwykły zestaw testów tego nie zauważa. Evals zamieniają „chyba działa” w zmierzoną jakość – trafność, oparcie w źródłach, ton, zgodność z zasadami – sprawdzaną przed każdym wydaniem.
Powiązane realizacje
Nasze projekty i produkty, w których była ta usługa.
Start
Powiedzcie nam, jakie funkcje AI uruchamiacie. Senior inżynier odpowie z uczciwym zakresem i ceną.
Let’s manage Zobaczcie analitykę wydajności