WNC LogoWNC
UsługiRozwiązaniaFirmaAcademyLabsKontakt
Otwórzcie Kanban

We No Code. We Architect.

Rozpocznijcie projekt daniel@we-nocode.com
WNC LogoWNC

Partner w zakresie AI i automatyzacji. Tworzone z troską w USA, Polsce, Estonii, Brazylii i Ukrainie.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
Remote-first, na całym świecie

Rozwiązania

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portale

  • Portal klienta
  • Portal inwestora
  • Portal partnera

Firma

  • O nas
  • Nasz zespół
  • Case studies
  • Opinie
  • Inwestycje
  • Blog
  • Wiadomości
  • Kariera
  • Lokalizacje
  • Kontakt

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Inicjatywy

  • Startup Program
  • Academy
  • Olymp Hill

Usługi

Wszystkie usługi
AI
  • Agentowe systemy AI
  • Agenci AI i copiloty
  • Serwery MCP
  • Potoki RAG
  • Głosowi agenci AI
  • Oprogramowanie zorientowane na AI
  • Automatyzacja procesów
  • LLMOps i evale
  • Fine-tuning i modele
  • AI dla dokumentów
  • Widzenie komputerowe
Rozwój oprogramowania
  • Rozwój webowy
  • Rozwój mobilny
  • Tworzenie SaaS i MVP
  • Projektowanie UI/UX
  • Integracje i API
  • Tworzenie e-commerce
  • Modernizacja systemów legacy
  • QA i automatyzacja testów
  • No-code i low-code
  • Rozwój desktopowy
Systemy wbudowane i IoT
  • Rozwiązania IoT
  • Firmware dla systemów wbudowanych
  • Wbudowany Linux i SoC
  • Edge AI i TinyML
  • Technologie bezprzewodowe i łączność
  • Prototypowanie sprzętu
  • Platforma IoT i chmura
  • Zarządzanie flotą i aktualizacje OTA
  • Przemysłowy IoT (IIoT)
  • Bezpieczeństwo IoT
Chmura i dane
  • Inżynieria danych
  • Chmurowa infrastruktura AI
  • Rozwój serwerowy
  • DevOps i platformy
  • Migracja i FinOps
  • BI i dashboardy
  • Analityka wydajności
  • Wsparcie i SRE
Bezpieczeństwo
  • Pentesty
  • Red teaming AI
  • Zgodność
  • Uwierzytelnianie
  • Bezpieczeństwo chmury
  • Bezpieczny SDLC
  • Łańcuch dostaw
  • Audyty bezpieczeństwa
  • Monitoring bezpieczeństwa
  • Zero trust
  • Prywatność i RODO
Doradztwo
  • Konsulting i usługi doradcze
  • CTO-as-a-service
  • Strategia i ład AI
  • Due diligence
  • Dedykowany zespół
  • Szkolenia AI dla firm
R&D / innowacje
  • Proof of concept i wykonalność
  • Szybkie prototypowanie
  • Stosowane badania AI
  • Rozpoznanie i poszukiwanie technologii

© 2026 WNC. Wszelkie prawa zastrzeżone.

🇺🇦Solidarni z Ukrainą

We No Code

Wszystkie usługi

Fine-tuning i własne modele

Model, który zna waszą pracę – na waszych warunkach.

Otwarte i małe modele językowe, dostrajane z evalami i uruchamiane tam, gdzie są wasze dane.

Uniwersalne modele robią wrażenie i dużo kosztują, a czasem po prostu nie pasują: są zbyt wolne, zbyt drogie przy dużej skali, nie mogą działać w waszej sieci albo są niestabilne w wąskim zadaniu. Dostrajamy i destylujemy otwarte i małe modele – Llama, Mistral, Qwen i inne – za pomocą LoRA i QLoRA, potwierdzamy zysk evalami względem modelu bazowego i wdrażamy je prywatnie. A gdy lepiej sprawdzi się wyszukiwanie (RAG), powiemy to najpierw.
Zarządzajmy Otwórzcie Kanban
Fine-tuning and custom language models

01 / Co to rozwiązuje

Mniejszy, szybszy, prywatny i mierzalnie lepszy.

01

Pod wasze zadanie

Spójny format, terminologia i zachowanie w wąskich zadaniach wykonywanych tysiące razy dziennie.

02

Działa tam, gdzie wasze dane

Wdrożenie w waszej chmurze, na własnych GPU lub sprzęcie edge – wrażliwe dane nie opuszczają środowiska.

03

Niższy koszt i opóźnienie

Mały dostrojony model może zastąpić duży uniwersalny w odpowiednim zadaniu, za ułamek kosztu zapytania.

04

Potwierdzone evalami

Kryteria sukcesu i odłożony zbiór testowy ustalone przed treningiem; model trafia do produkcji tylko, jeśli wygrywa.

02 / Stos

Technologie, na których budujemy.

Standardy branżowe, nudne w dobrym sensie: narzędzia z przyszłością, które będzie znał także następny inżynier.

Otwarte modele

  • Llama

    Otwarta rodzina modeli od Meta

  • Mistral

    Wydajne otwarte modele z Europy

  • Qwen

    Mocne wielojęzyczne modele otwarte

  • Gemma

    Lekkie otwarte modele od Google

Trening

  • LoRA / QLoRA

    Dostrajanie oszczędne w parametrach

  • Distillation

    Uczenie małego modelu od dużego

  • Hugging Face

    Hub modeli i biblioteki treningowe

  • PyTorch

    Framework do deep learningu

Serwowanie

  • vLLM

    Wydajne serwowanie modeli

  • Ollama

    Lokalne uruchamianie dla zespołów i edge

  • NVIDIA GPUs

    Akceleracja GPU w chmurze i on-premise

  • Quantisation

    Mniejsze, szybsze modele na tańszy sprzęt

03 / Podejście

Jak tworzymy to, co służy długo.

01

RAG czy fine-tuning? Najpierw decyzja

Sprawdzamy, czy brakuje wiedzy, zachowania czy niższego kosztu, zanim w ogóle zarekomendujemy trening.

02

Dane przed treningiem

Wyselekcjonowane, bez duplikatów i bezpieczne dla prywatności przykłady znaczą więcej niż rozmiar modelu; zbiór budujemy razem z wami.

03

Iteracje sterowane evalami

Każdy trening porównujemy z modelem bazowym i mocnym modelem hostowanym na waszym zbiorze testowym.

04

Wdrożenie pod waszą kontrolą

Skwantyzowane modele na waszej infrastrukturze z monitoringiem, wersjami i możliwością wycofania.

04 / Standardy

Najlepsze praktyki, których nie zaniedbujemy.

Trzymamy się standardów branżowych i sprawdzonych metod w każdym projekcie – to właśnie dzięki nim wycena pozostaje realistyczna.

  • Odłożony zbiór testowy ustalony przed treningiem
  • Weryfikacja licencji każdego modelu bazowego
  • Dane osobowe usunięte ze zbiorów treningowych
  • Dane syntetyczne sprawdzane, nigdy przyjmowane w ciemno
  • Adaptery wersjonowane razem z promptami
  • Kwantyzacja mierzona względem utraty jakości
  • Przejście na model hostowany przy niskiej pewności
  • Ponowny trening przy dryfie evali, nie według kalendarza

05 / Infrastruktura

Gdzie to działa i jak pozostaje dostępne.

  • Potok treningowy ze śledzonymi zbiorami i przebiegami
  • Adaptery LoRA lub destylowane małe modele
  • Serwowanie vLLM w chmurze, on-premise lub na GPU edge
  • Evale i monitoring wdrożonego modelu

Dobre pytania

O co nas pytają

Konkretne odpowiedzi na pytania klientów przed startem.

Często nie. Jeśli brakuje wiedzy, wyszukiwanie (RAG) jest zwykle tańsze i łatwiej utrzymać je aktualne. Fine-tuning opłaca się przy stałym formacie lub stylu, wąskim, powtarzalnym zadaniu, niższych opóźnieniach lub kosztach dzięki mniejszemu modelowi albo działaniu w całości na waszej infrastrukturze. WNC powie, co dotyczy waszego przypadku, zanim cokolwiek zostanie wytrenowane.

Powiązane realizacje

Gdzie już to robiliśmy

Nasze projekty i produkty, w których była ta usługa.

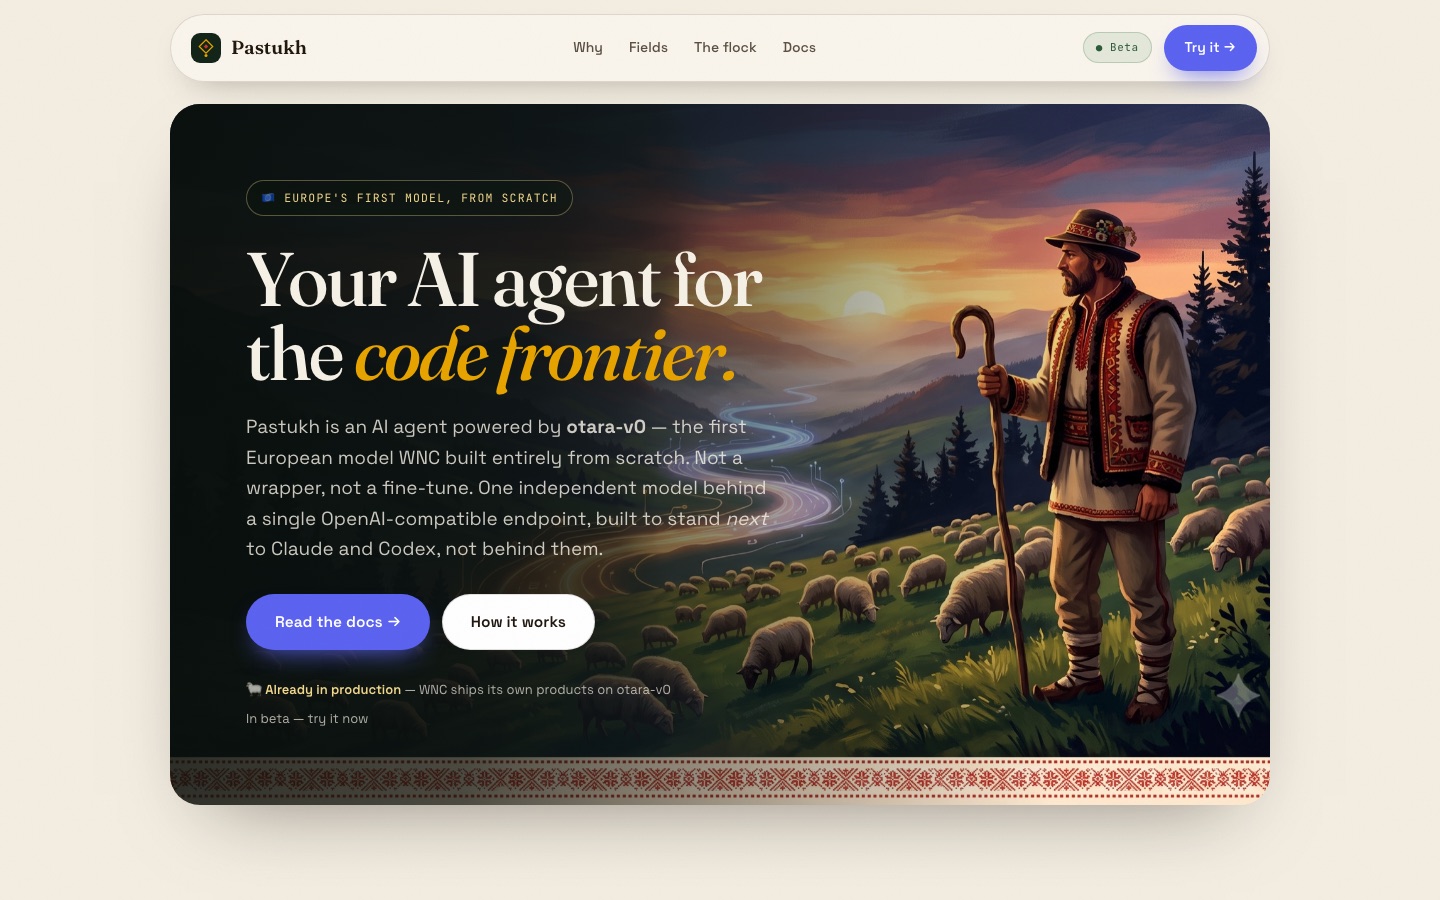
Pastukh
Nasz produkt

Pastukh

Agent AI do programowania oparty na otara-v0 – modelu, który WNC zbudowało od zera, a nie nakładce czy dostrojeniu – za jednym endpointem zgodnym z OpenAI. W wersji beta.

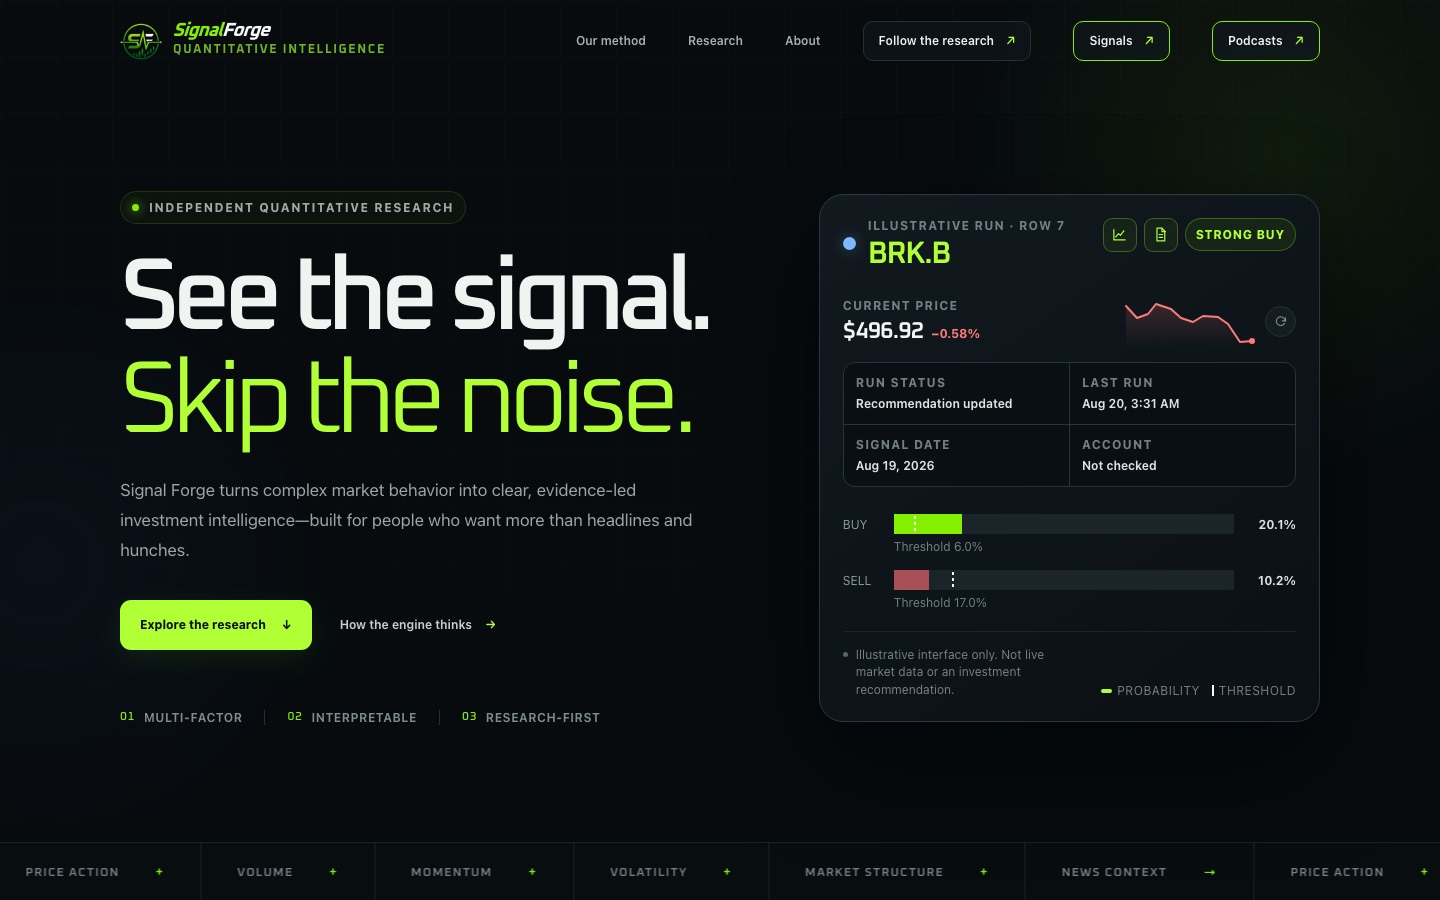
Signal Forge
AI · Finanse ilościowe

Signal Forge

Analityka ilościowa dla mądrzejszego inwestowania: silnik, który zamienia złożone zachowanie rynku w jasne, oparte na dowodach sygnały Buy, Hold lub Sell – zbudowany z Alexandrem Groverem, wcześniej jako TickerPulse.

Start

Gotowy na model, który pasuje do zadania?

Powiedzcie nam, co ma robić model i gdzie ma działać. Senior inżynier odpowie z uczciwym zakresem i ceną.

Let’s manage Zobaczcie potoki RAG