WNC LogoWNC
UsługiRozwiązaniaFirmaAcademyLabsKontakt
Otwórzcie Kanban

We No Code. We Architect.

Rozpocznijcie projekt daniel@we-nocode.com
WNC LogoWNC

Partner w zakresie AI i automatyzacji. Tworzone z troską w USA, Polsce, Estonii, Brazylii i Ukrainie.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
Remote-first, na całym świecie

Rozwiązania

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portale

  • Portal klienta
  • Portal inwestora
  • Portal partnera

Firma

  • O nas
  • Nasz zespół
  • Case studies
  • Opinie
  • Inwestycje
  • Blog
  • Wiadomości
  • Kariera
  • Lokalizacje
  • Kontakt

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Inicjatywy

  • Startup Program
  • Academy
  • Olymp Hill

Usługi

Wszystkie usługi
AI
  • Agentowe systemy AI
  • Agenci AI i copiloty
  • Serwery MCP
  • Potoki RAG
  • Głosowi agenci AI
  • Oprogramowanie zorientowane na AI
  • Automatyzacja procesów
  • LLMOps i evale
  • Fine-tuning i modele
  • AI dla dokumentów
  • Widzenie komputerowe
Rozwój oprogramowania
  • Rozwój webowy
  • Rozwój mobilny
  • Tworzenie SaaS i MVP
  • Projektowanie UI/UX
  • Integracje i API
  • Tworzenie e-commerce
  • Modernizacja systemów legacy
  • QA i automatyzacja testów
  • No-code i low-code
  • Rozwój desktopowy
Systemy wbudowane i IoT
  • Rozwiązania IoT
  • Firmware dla systemów wbudowanych
  • Wbudowany Linux i SoC
  • Edge AI i TinyML
  • Technologie bezprzewodowe i łączność
  • Prototypowanie sprzętu
  • Platforma IoT i chmura
  • Zarządzanie flotą i aktualizacje OTA
  • Przemysłowy IoT (IIoT)
  • Bezpieczeństwo IoT
Chmura i dane
  • Inżynieria danych
  • Chmurowa infrastruktura AI
  • Rozwój serwerowy
  • DevOps i platformy
  • Migracja i FinOps
  • BI i dashboardy
  • Analityka wydajności
  • Wsparcie i SRE
Bezpieczeństwo
  • Pentesty
  • Red teaming AI
  • Zgodność
  • Uwierzytelnianie
  • Bezpieczeństwo chmury
  • Bezpieczny SDLC
  • Łańcuch dostaw
  • Audyty bezpieczeństwa
  • Monitoring bezpieczeństwa
  • Zero trust
  • Prywatność i RODO
Doradztwo
  • Konsulting i usługi doradcze
  • CTO-as-a-service
  • Strategia i ład AI
  • Due diligence
  • Dedykowany zespół
  • Szkolenia AI dla firm
R&D / innowacje
  • Proof of concept i wykonalność
  • Szybkie prototypowanie
  • Stosowane badania AI
  • Rozpoznanie i poszukiwanie technologii

© 2026 WNC. Wszelkie prawa zastrzeżone.

🇺🇦Solidarni z Ukrainą

We No Code

Wszystkie usługi

Edge AI i TinyML

Wasz produkt widzi, słyszy i decyduje samodzielnie.

Natychmiastowe odpowiedzi, bez rachunków za chmurę i bez danych opuszczających urządzenie.

Gdy produkt musi zareagować w tej samej chwili, gdy coś się dzieje, podróż do chmury jest zbyt wolna, zbyt droga i przestaje działać, gdy tylko zrywa się łączność. Stawiamy model na samym urządzeniu, więc odpowiada w milisekundach, działa dalej offline, a dane, które odczytuje, nie muszą nigdzie opuszczać rąk klienta. To modele z naszych AI Labs, dopasowane tak, by zmieściły mikrokontroler, Jetson lub NPU w waszym SoC.
Zarządzajmy Otwórzcie Kanban
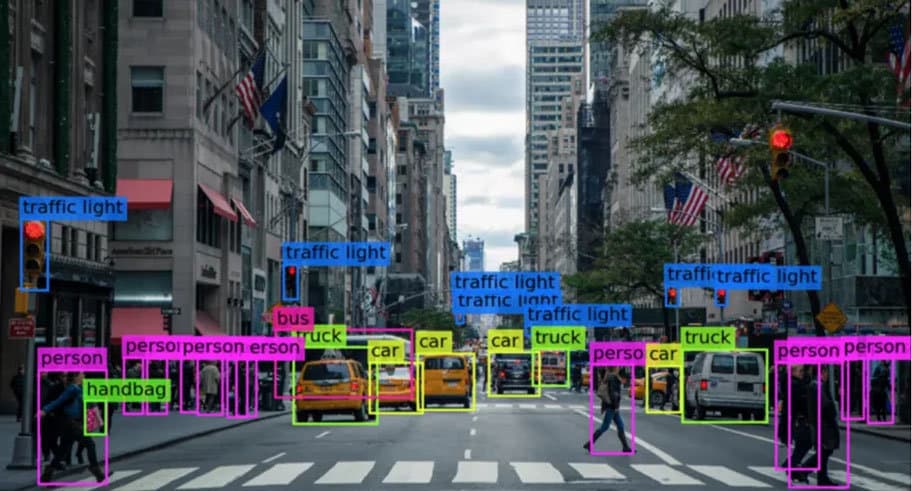
Komputerowe widzenie działające na urządzeniu brzegowym

01 / Co to rozwiązuje

Produkty, które reagują samodzielnie.

01

Widzieć i działać w czasie rzeczywistym

Natychmiast dostrzegajcie, liczcie i śledźcie to, co ważne, w strumieniu wideo, od maleńkiego czujnika na Cortex-M po wielokamerowy system na Jetson.

02

Reagować na głos, bez użycia rąk

Słowa aktywujące, polecenia głosowe i powiadomienia dźwiękowe przetwarzane na urządzeniu, bez wysyłania dźwięku dokądkolwiek.

03

Łapać problemy, zanim drogo wyjdą

Konserwacja predykcyjna, rozpoznawanie gestów i aktywności odczytywane wprost z pokładowych czujników.

04

Staje się lepszy także po premierze

Jeden cykl od danych do uczenia, ewaluacji na urządzeniu i aktualizacji OTA, więc produkt poprawia się w warunkach polowych.

02 / Stos

Technologie, na których budujemy.

Standardy branżowe, nudne w dobrym sensie: narzędzia z przyszłością, które będzie znał także następny inżynier.

Środowiska wnioskowania

  • TensorFlow Lite / LiteRT

    Skwantowane modele na MCU i mobilnych SoC

  • ONNX Runtime

    Przenośne wnioskowanie na CPU, GPU i NPU

  • TensorRT & DeepStream

    Potoki widzenia z przyspieszeniem na GPU na Jetson

  • Edge Impulse & TinyML

    Szybka iteracja modeli dla ograniczonych celów

Sprzęt docelowy

  • Cortex-M with CMSIS-NN

    Rozpoznawanie słów kluczowych i wykrywanie anomalii w kilobajtach

  • NVIDIA Jetson

    Wielokamerowe widzenie na brzegu

  • Google Coral / Hailo

    Dedykowane akceleratory do niskonapięciowego wnioskowania

  • Qualcomm & NXP NPUs

    Przyspieszanie na SoC w urządzeniach seryjnych

Potok modeli

  • PyTorch

    Uczenie, dystylacja i eksport

  • Quantisation & pruning

    Modele INT8 / INT4, które zachowują dokładność

  • Evals on-device

    Dokładność, opóźnienie i pobór energii zmierzone na celu

  • OTA model delivery

    Modele dostarczane i wycofywane jak firmware

03 / Podejście

Jak tworzymy to, co służy długo.

01

Zmierzone na celu

Opóźnienie, pamięć i pobór prądu mierzone na rzeczywistym urządzeniu dla każdej rewizji modelu.

02

Miliwaty, a nie waty

Wnioskowanie w trybie cyklicznym i akceleratory dobrane pod budżet energetyczny, który produkt naprawdę ma.

03

Prywatność od założenia

Surowe dane pozostają na urządzeniu; opuszcza je tylko to, czego potrzebuje produkt – o ile w ogóle cokolwiek je opuszcza.

04

Jeden potok, od urządzenia do chmury

Dane z floty zasilają uczenie; lepszy model wraca z powrotem jako zwykła aktualizacja.

04 / Standardy

Najlepsze praktyki, których nie zaniedbujemy.

Trzymamy się standardów branżowych i sprawdzonych metod w każdym projekcie – to właśnie dzięki nim wycena pozostaje realistyczna.

  • Zacznijcie od najmniejszego modelu, który może zadziałać – destylowane lub kwantyzowane małe modele przed dużymi
  • Uczenie z uwzględnieniem kwantyzacji przed sztuczkami etapu po-treningowego
  • Ewaluacja dokładności na rzeczywistych nagraniach z urządzenia, a nie na zbiorze laboratoryjnym
  • Budżety opóźnienia i poboru energii ustalone jako kryteria odbioru
  • Zdefiniowane zachowanie zapasowe dla wyników o niskiej pewności
  • Wersjonowanie modeli i wycofywanie przez kanał OTA
  • Monitorowanie dryfu z telemetrii floty, z ponownym trenowaniem dostarczanym przez OTA
  • Przegląd prywatności każdego sygnału, który opuszcza urządzenie

05 / Infrastruktura

Gdzie to działa i jak pozostaje dostępne.

  • Stanowiska do benchmarkingu na urządzeniu (opóźnienie, pamięć, pobór energii)
  • Potok uczenia zasilany danymi floty
  • Dostarczanie modeli przez OTA z wycofywaniem
  • Monitoring dryfu i dokładności na produkcji

Dobre pytania

O co nas pytają

Konkretne odpowiedzi na pytania klientów przed startem.

Tak, jeśli pozwala na to sprzęt. WNC zaczyna od najmniejszego modelu, który wykona zadanie, destylowanego lub skwantyzowanego, i wdraża go na NVIDIA Jetson i podobnych NPU, a budżety opóźnień i zużycia energii są kryteriami odbioru.

Powiązane realizacje

Gdzie już to robiliśmy

Nasze projekty i produkty, w których była ta usługa.

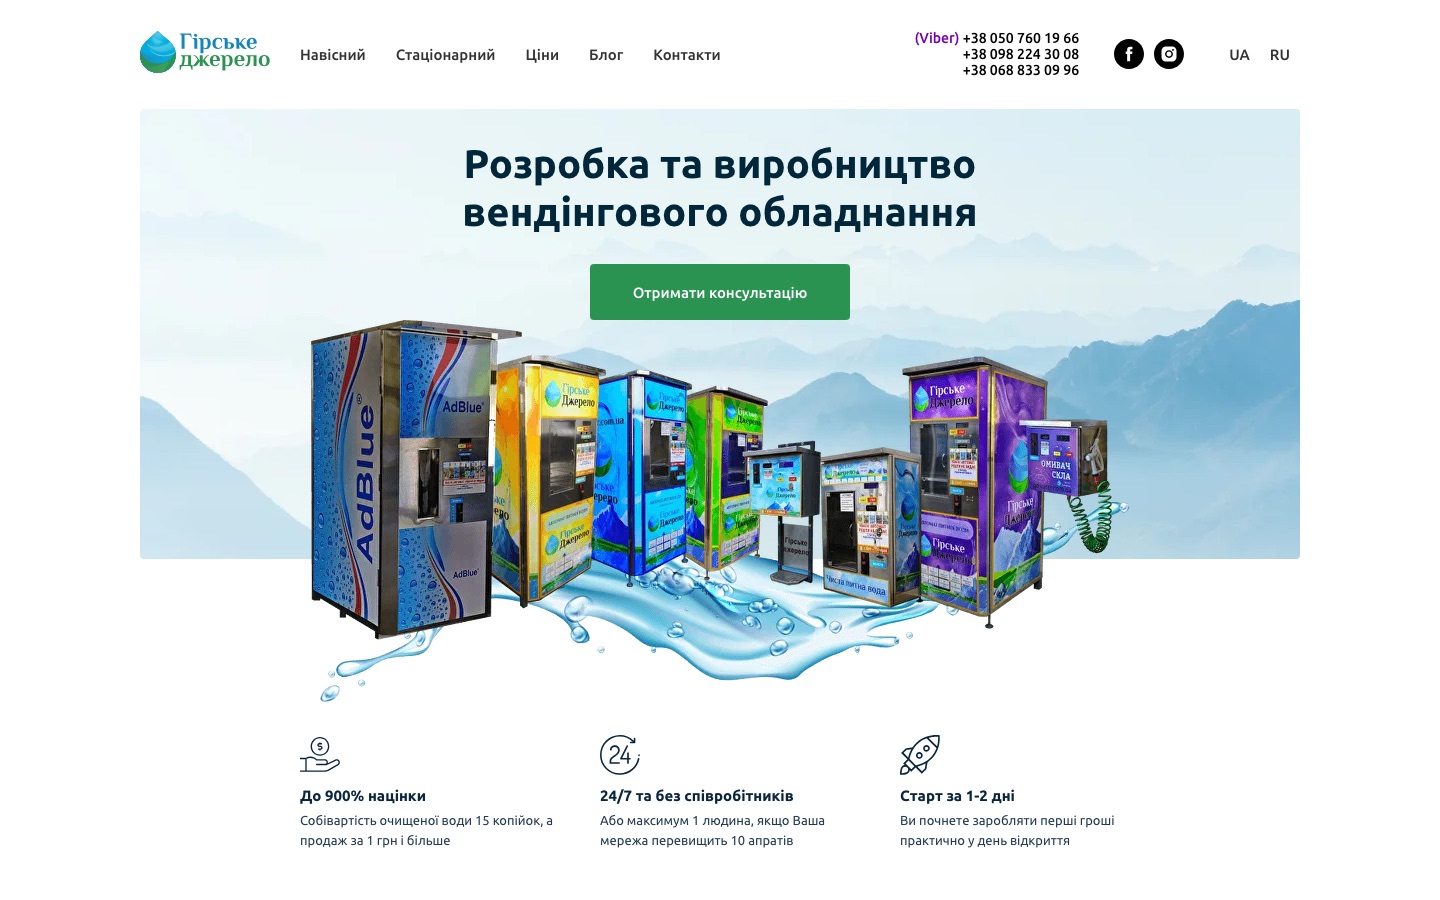
Hirske Dzherelo
IoT · Produkcja

Hirske Dzherelo

IoT dla fabryki produkującej automaty z wodą pitną: każdy automat raportuje do serwera co 3–5 sekund i jest monitorowany oraz konfigurowany zdalnie, z panelu webowego i bota w Telegramie.

IoT · TelekomunikacjaPlatforma analityki usług IoT dla operatorów komórkowych
IoT · Telekomunikacja

Platforma analityki usług IoT dla operatorów komórkowych

Od łączności do analityki: platforma działająca nad istniejącymi systemami operatora, która zamienia rozproszone dane o kartach SIM, urządzeniach, ruchu i usługach w widoczność, zaufanie i działanie dla klientów biznesowych.

Start

Chcecie model na urządzeniu?

Opowiedzcie, co ma widzieć, słyszeć lub przewidywać i na jakim sprzęcie. Inżynier odpowie z uczciwym zakresem prac i ceną.

Let’s manage albo poznajcie AI Labs