WNC LogoWNC
UsługiRozwiązaniaFirmaAcademyLabsKontakt
Otwórzcie Kanban

We No Code. We Architect.

Rozpocznijcie projekt daniel@we-nocode.com
WNC LogoWNC

Partner w zakresie AI i automatyzacji. Tworzone z troską w USA, Polsce, Estonii, Brazylii i Ukrainie.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
Remote-first, na całym świecie

Rozwiązania

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portale

  • Portal klienta
  • Portal inwestora
  • Portal partnera

Firma

  • O nas
  • Nasz zespół
  • Case studies
  • Opinie
  • Inwestycje
  • Blog
  • Wiadomości
  • Kariera
  • Lokalizacje
  • Kontakt

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Inicjatywy

  • Startup Program
  • Academy
  • Olymp Hill

Usługi

Wszystkie usługi
AI
  • Agentowe systemy AI
  • Agenci AI i copiloty
  • Serwery MCP
  • Potoki RAG
  • Głosowi agenci AI
  • Oprogramowanie zorientowane na AI
  • Automatyzacja procesów
  • LLMOps i evale
  • Fine-tuning i modele
  • AI dla dokumentów
  • Widzenie komputerowe
Rozwój oprogramowania
  • Rozwój webowy
  • Rozwój mobilny
  • Tworzenie SaaS i MVP
  • Projektowanie UI/UX
  • Integracje i API
  • Tworzenie e-commerce
  • Modernizacja systemów legacy
  • QA i automatyzacja testów
  • No-code i low-code
  • Rozwój desktopowy
Systemy wbudowane i IoT
  • Rozwiązania IoT
  • Firmware dla systemów wbudowanych
  • Wbudowany Linux i SoC
  • Edge AI i TinyML
  • Technologie bezprzewodowe i łączność
  • Prototypowanie sprzętu
  • Platforma IoT i chmura
  • Zarządzanie flotą i aktualizacje OTA
  • Przemysłowy IoT (IIoT)
  • Bezpieczeństwo IoT
Chmura i dane
  • Inżynieria danych
  • Chmurowa infrastruktura AI
  • Rozwój serwerowy
  • DevOps i platformy
  • Migracja i FinOps
  • BI i dashboardy
  • Analityka wydajności
  • Wsparcie i SRE
Bezpieczeństwo
  • Pentesty
  • Red teaming AI
  • Zgodność
  • Uwierzytelnianie
  • Bezpieczeństwo chmury
  • Bezpieczny SDLC
  • Łańcuch dostaw
  • Audyty bezpieczeństwa
  • Monitoring bezpieczeństwa
  • Zero trust
  • Prywatność i RODO
Doradztwo
  • Konsulting i usługi doradcze
  • CTO-as-a-service
  • Strategia i ład AI
  • Due diligence
  • Dedykowany zespół
  • Szkolenia AI dla firm
R&D / innowacje
  • Proof of concept i wykonalność
  • Szybkie prototypowanie
  • Stosowane badania AI
  • Rozpoznanie i poszukiwanie technologii

© 2026 WNC. Wszelkie prawa zastrzeżone.

🇺🇦Solidarni z Ukrainą

We No Code

Wszystkie usługi

Inżynieria danych

Dane, którym może zaufać wasze AI i wasz zespół.

Lakehouse, streaming i zarządzane pipeline’y – zbudowane, by zasilać analitykę i AI.

Większość projektów AI grzęźnie na danych, a nie na modelu: dane są w silosach, docierają z opóźnieniem i nikt nie wie, skąd wzięła się dana liczba. Budujemy platformę danych pod spodem: lakehouse na otwartych formatach, pipeline’y wsadowe i strumieniowe oraz katalog, który decyduje, kto i co może je czytać, żeby dashboardy były aktualne, a wasze agenty AI i pipeline’y RAG pracowały na danych, za które możecie ręczyć.
Zarządzajmy Otwórzcie Kanban
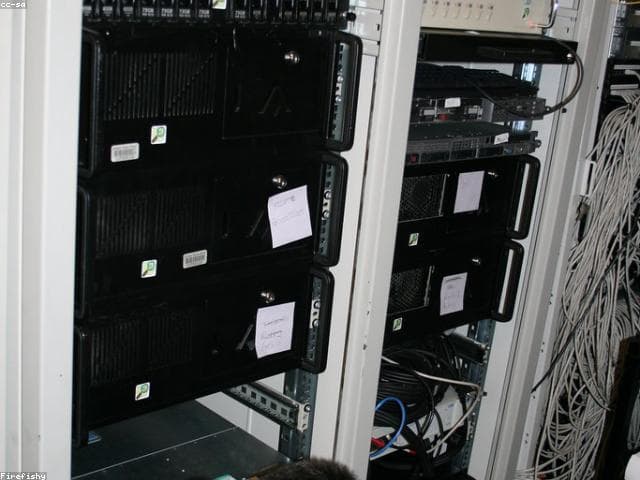
Data platform: database storage and pipelines

01 / Co to rozwiązuje

Od rozproszonych źródeł do jednej zarządzanej platformy.

01

Jeden lakehouse, otwarte formaty

Wasze dane w tabelach Apache Iceberg lub Delta Lake, które czytają Databricks, Snowflake, BigQuery i Spark, bez uzależnienia od dostawcy i bez kopii dla każdego narzędzia.

02

Czas rzeczywisty tam, gdzie ma znaczenie

Pipeline’y na Kafce i Flinku zapisują zdarzenia prosto do tabel lakehouse, więc dashboardy operacyjne i agenty AI widzą to, co stało się kilka minut temu, a nie wczoraj.

03

Dane gotowe na AI

Czyste, wersjonowane, udokumentowane zbiory danych, embeddingi i cechy, z których pipeline’y RAG, agenty i modele mogą bezpiecznie korzystać, także dokumenty, obrazy i inne dane multimodalne.

04

Zarządzane i identyfikowalne

Katalog jako jedyny punkt kontroli: zasady dostępu, lineage od źródła do raportu, kontrakty danych i testy jakości, które wyłapują zepsute dane, zanim zrobią to wasi użytkownicy.

02 / Stos

Technologie, na których budujemy.

Standardy branżowe, nudne w dobrym sensie: narzędzia z przyszłością, które będzie znał także następny inżynier.

Lakehouse i formaty tabel

  • Apache Iceberg

    Otwarty format tabel, czytelny dla każdego dużego silnika

  • Delta Lake

    Otwarty format tabel natywny dla Databricks

  • Databricks

    Platforma lakehouse dla danych i AI

  • Snowflake

    Chmurowa platforma danych z tabelami Iceberg

  • BigQuery

    Bezserwerowa hurtownia w Google Cloud

Streaming

  • Apache Kafka

    Kręgosłup strumieni zdarzeń

  • Apache Flink

    Stanowe przetwarzanie strumieni

  • Spark Structured Streaming

    Spark Structured Streaming: wsad i strumień w jednym

  • Amazon Kinesis

    Zarządzany streaming w AWS

Transformacje i orkiestracja

  • dbt

    Przetestowane, wersjonowane transformacje SQL

  • Apache Airflow

    Orkiestracja procesów na dużą skalę

  • Dagster

    Orkiestracja oparta na zasobach z lineage

  • Apache Spark

    Rozproszone przetwarzanie dużych zbiorów danych

Zarządzanie i jakość

  • Unity Catalog

    Kontrola dostępu, lineage i wyszukiwanie danych

  • Apache Polaris

    Otwarty katalog REST dla Iceberga

  • Great Expectations

    Automatyczne testy jakości danych

  • OpenLineage

    Otwarty standard lineage między narzędziami

Dane dla AI

  • Vector stores

    pgvector, Qdrant, Pinecone i wyszukiwanie wektorowe wprost w lakehouse

  • Feature stores

    Feature store’y dla spójnych cech w treningu i na produkcji

  • Document pipelines

    Pobieranie dokumentów i danych multimodalnych dla RAG

  • MCP servers

    Zarządzany dostęp agentów AI do danych przez serwery MCP

03 / Podejście

Jak tworzymy to, co służy długo.

01

Najpierw otwarte formaty

Tabele Iceberg lub Delta, które należą do was – później możecie zmienić lub połączyć silniki bez ponownej migracji danych.

02

Wsad i strumień, jeden model

Te same tabele obsługują nocne raporty i scenariusze czasu rzeczywistego zamiast dwóch pipeline’ów, które pokazują co innego.

03

Kontrakty i testy

Kontrakty danych między producentami a odbiorcami i testy jakości przy każdym uruchomieniu, żeby zmiana schematu wyżej w łańcuchu po cichu nie psuła raportów ani odpowiedzi AI.

04

Koszty pod kontrolą

Moc obliczeniowa dopasowana do obciążenia, warstwy przechowywania i wgląd w zużycie – rachunek rośnie razem z wartością, a nie niespodziewanie.

04 / Standardy

Najlepsze praktyki, których nie zaniedbujemy.

Trzymamy się standardów branżowych i sprawdzonych metod w każdym projekcie – to właśnie dzięki nim wycena pozostaje realistyczna.

  • Warstwowy model danych bronze, silver i gold
  • Ładowanie przyrostowe i change data capture (CDC)
  • Idempotentne pipeline’y, które można bezpiecznie powtórzyć
  • Kontrolowana ewolucja schematu
  • Pełny lineage od źródła do dashboardu
  • Zasady dostępu na poziomie wierszy i kolumn
  • Wykrywanie i maskowanie danych osobowych, zasady przechowywania
  • Monitorowanie świeżości, wolumenu i jakości z alertami
  • Udokumentowane, łatwe do znalezienia w katalogu zbiory danych
  • Monitorowanie kosztów i dopasowanie mocy obliczeniowej

05 / Infrastruktura

Gdzie to działa i jak pozostaje dostępne.

  • Lakehouse na AWS, Google Cloud, Azure lub Databricks
  • Streaming Kafka / Flink do tabel Iceberg lub Delta
  • Modele dbt orkiestrowane przez Airflow lub Dagster
  • Katalog, lineage i testy jakości w każdym pipeline’ie

Dobre pytania

O co nas pytają

Konkretne odpowiedzi na pytania klientów przed startem.

To zależy od waszych obciążeń. WNC zwykle zaleca przechowywanie danych w otwartym formacie tabel, takim jak Apache Iceberg lub Delta Lake, aby hurtownia (Snowflake, BigQuery) i silnik lakehouse (Databricks, Spark) czytały te same tabele. Zachowujecie wygodę hurtowni tam, gdzie się sprawdza, i nie wiążecie danych z jednym silnikiem.

Powiązane realizacje

Gdzie już to robiliśmy

Nasze projekty i produkty, w których była ta usługa.

IoT · TelekomunikacjaPlatforma analityki usług IoT dla operatorów komórkowych
IoT · Telekomunikacja

Platforma analityki usług IoT dla operatorów komórkowych

Od łączności do analityki: platforma działająca nad istniejącymi systemami operatora, która zamienia rozproszone dane o kartach SIM, urządzeniach, ruchu i usługach w widoczność, zaufanie i działanie dla klientów biznesowych.

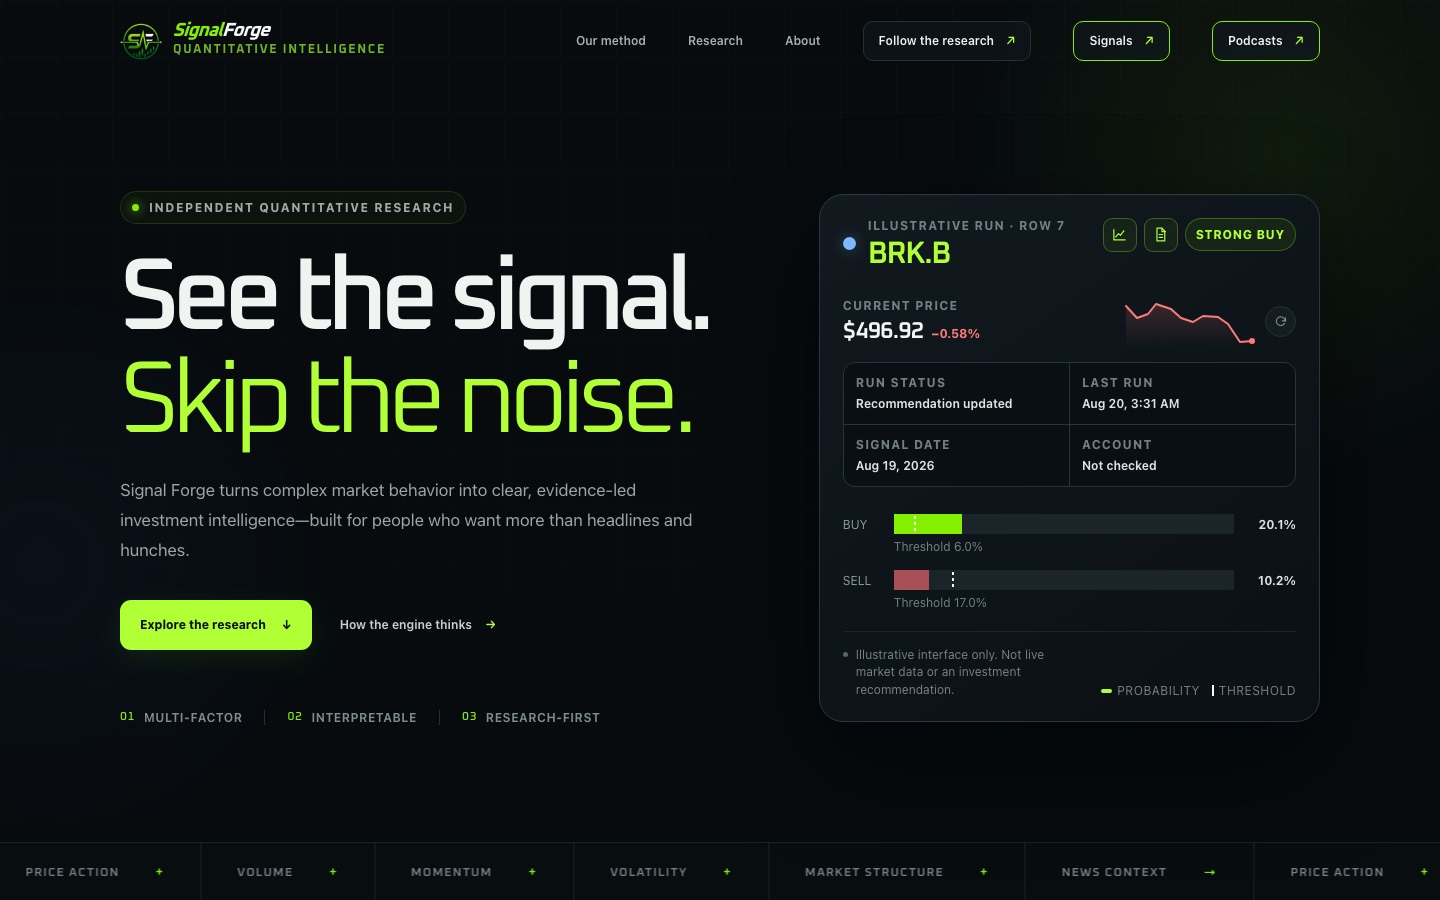
Signal Forge
AI · Finanse ilościowe

Signal Forge

Analityka ilościowa dla mądrzejszego inwestowania: silnik, który zamienia złożone zachowanie rynku w jasne, oparte na dowodach sygnały Buy, Hold lub Sell – zbudowany z Alexandrem Groverem, wcześniej jako TickerPulse.

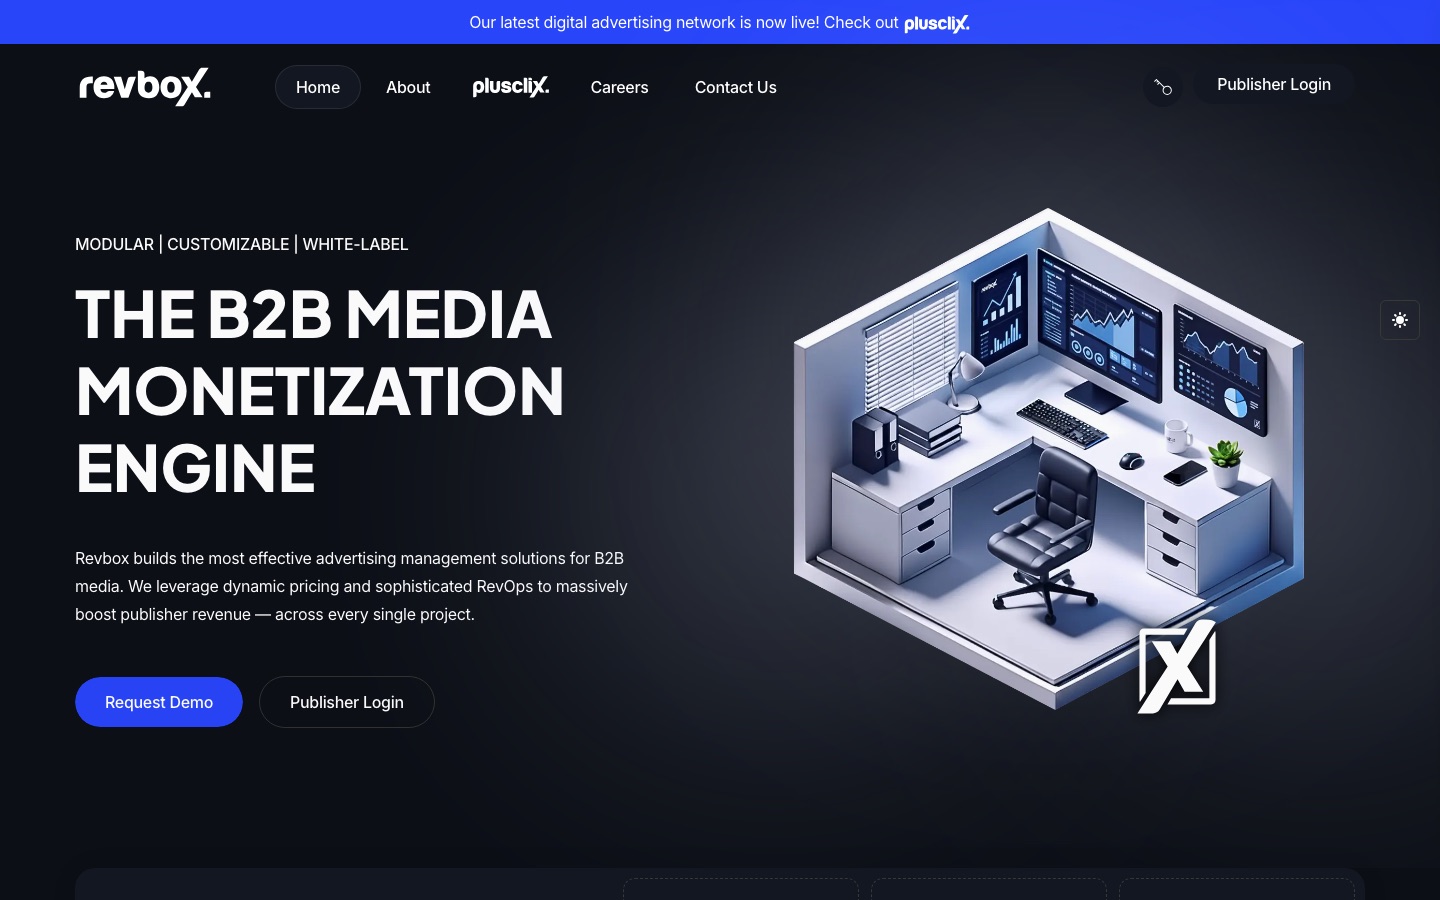
Revbox
Monetyzacja mediów B2B

Revbox

Silnik monetyzacji mediów B2B: aukcje, sklepy white-label, analityka i automatyzacja RevOps, które pomagają wydawcom B2B zwiększać przychody z reklam.

Start

Gotowy, by dane zaczęły pracować?

Napiszcie, gdzie dziś są wasze dane i co mają zasilać. Starszy inżynier odpowie z uczciwym zakresem i ceną.

Let’s manage Zobaczcie pipeline’y RAG