LLMOps, evals y guardrails
Evals, trazas, guardrails y control de costes: la capa de operaciones para aplicaciones LLM.
Lanzar una función de IA es lo fácil; mantenerla precisa, segura y asequible mientras cambian prompts, modelos y datos es el trabajo. Montamos la capa de operaciones alrededor de tus aplicaciones LLM: suites de evals y LLM-as-a-judge que puntúan cada versión, trazas que muestran qué vio e hizo el modelo, guardrails que frenan entradas y salidas inseguras, y control de coste y latencia con enrutado de modelos, para que la calidad se mida y no se suponga.
01 / Qué resuelve
Conjuntos de referencia y jueces que puntúan precisión, fundamentación, tono y políticas, para que un cambio de prompt o de modelo no empeore nada en silencio.
Trazas de prompts, recuperaciones, llamadas a herramientas y respuestas, vinculadas a usuarios y versiones, para depurar rápido.
Controles de prompt injection, fuga de datos, temas ajenos y contenido inseguro en la entrada y la salida.
Coste por petición y por función, caché y enrutado a modelos más pequeños cuando la calidad lo permite.
02 / Stack
Estándar del sector, aburrida en el buen sentido: herramientas con futuro, que el próximo ingeniero también conocerá.
Trazas y observabilidad
Langfuse
Trazas y analítica de LLM de código abierto
OpenTelemetry
Estándar de telemetría neutral
MLflow
Seguimiento de experimentos y evaluación
Arize Phoenix
Observabilidad de LLM de código abierto
Evaluación
LLM-as-a-judge
Puntuación por modelo con criterios claros
Golden datasets
Conjuntos de prueba a partir de tráfico real
Promptfoo
Pruebas de prompts y regresiones en CI
Ragas
Métricas de calidad de recuperación y RAG
Guardrails y control
Guardrail models
Controles de seguridad en entrada y salida
LLM gateway
Un punto de entrada para enrutado, límites y claves
Prompt registry
Prompts versionados con vuelta atrás
Semantic caching
Reutilizar respuestas a preguntas repetidas
03 / Enfoque
Acordamos contigo qué es una buena respuesta y lo convertimos en criterios y casos de prueba antes de ajustar nada.
Cada cambio en prompts, modelos o datos ejecuta la suite; una regresión bloquea la versión como un test fallido.
El enrutado manda lo simple a modelos pequeños y baratos y lo difícil a los más potentes, con alternativas.
Puntuación de una muestra del tráfico real y alertas cuando se mueven la calidad, el coste o la latencia.
04 / Estándares
Seguimos estándares del sector y métodos probados en cada proyecto: son los que hacen que el presupuesto se mantenga.
05 / Infraestructura
Buenas preguntas
Respuestas directas a lo que preguntan los clientes antes de empezar.
Porque su comportamiento cambia al editar un prompt, cambiar de modelo o actualizar los datos, y nada en una batería de pruebas normal lo detecta. Las evals convierten el «parece que funciona» en calidad medida (precisión, fundamentación, tono, cumplimiento de políticas) comprobada antes de cada versión.
Trabajo relacionado
Proyectos y productos nuestros en los que intervino este servicio.
Start
Cuéntanos qué funciones de IA tienes en marcha. Un ingeniero sénior te responde con un alcance y un precio honestos.
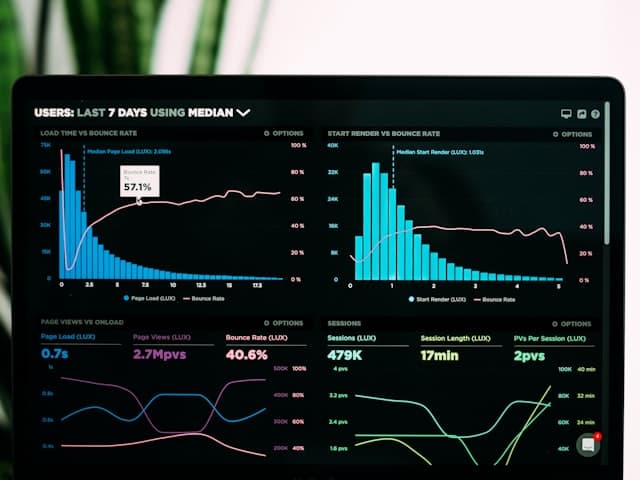
Let’s manage Ver analítica de rendimiento