WNC LogoWNC
ServiciosSolucionesEmpresaAcademiaLabsContacto
Abrir Kanban

We No Code. We Architect.

Empezar un proyecto daniel@we-nocode.com
WNC LogoWNC

Socio de IA y automatización. Hecho con cuidado en EE. UU., Polonia, Estonia, Brasil y Ucrania.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
Remoto ante todo, en cualquier parte del mundo

Soluciones

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Portales

  • Portal de cliente
  • Portal de inversores
  • Portal de socios

Empresa

  • Sobre nosotros
  • Nuestro equipo
  • Casos de estudio
  • Testimonios
  • Inversión
  • Blog
  • Noticias
  • Empleo
  • Ubicaciones
  • Contacto

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Iniciativas

  • Startup Program
  • Academy
  • Olymp Hill

Servicios

Todos los servicios
IA
  • Sistemas de IA agéntica
  • Agentes de IA y copilotos
  • Servidores MCP
  • Pipelines RAG
  • Agentes de voz IA
  • Software nativo de IA
  • Automatización de flujos de trabajo
  • LLMOps y evals
  • Fine-tuning y modelos
  • IA documental
  • Visión por computador
Desarrollo
  • Desarrollo web
  • Desarrollo móvil
  • Desarrollo de SaaS y MVP
  • Diseño UI/UX y de producto
  • Integraciones y APIs
  • Desarrollo de e-commerce
  • Modernización legacy
  • QA y pruebas automáticas
  • No-code y low-code
  • Desarrollo de escritorio
Embebido e IoT
  • Soluciones IoT
  • Firmware embebido
  • Linux embebido y SoC
  • Edge AI y TinyML
  • Conectividad inalámbrica
  • Prototipado de hardware
  • Plataforma y nube IoT
  • Gestión de flota y OTA
  • IoT industrial (IIoT)
  • Seguridad IoT
Nube y datos
  • Ingeniería de datos
  • Infraestructura de IA en la nube
  • Desarrollo de servidores
  • DevOps y plataformas
  • Migración y FinOps
  • BI y dashboards
  • Analítica de rendimiento
  • Soporte y SRE
Seguridad
  • Pentesting
  • Red teaming de IA
  • Cumplimiento
  • Autenticación
  • Seguridad en la nube
  • Desarrollo seguro
  • Cadena de suministro
  • Auditorías de seguridad
  • Monitorización
  • Zero trust
  • Privacidad y RGPD
Consultoría
  • Consultoría y asesoría
  • CTO como servicio
  • Estrategia y gobierno IA
  • Due diligence técnica
  • Equipo dedicado
  • Formación en IA para empresas
I+D / innovación
  • Prueba de concepto y viabilidad
  • Prototipado rápido
  • Investigación en IA aplicada
  • Descubrimiento tecnológico

© 2026 WNC. Todos los derechos reservados.

🇺🇦Apoya a Ucrania

We No Code

Todos los servicios

Edge AI y TinyML

Tu producto ve, oye y decide por sí mismo.

Respuestas instantáneas, sin factura en la nube, y datos que nunca salen del dispositivo.

Cuando un producto tiene que reaccionar en el momento en que algo ocurre, ir y volver a la nube es demasiado lento, demasiado caro y deja de funcionar en cuanto cae la conexión. Ponemos el modelo en el propio dispositivo, para que responda en milisegundos, siga funcionando sin conexión y los datos que lee nunca tengan que salir de las manos del cliente. Son los modelos de nuestros AI Labs adaptados para caber en un microcontrolador, una Jetson o la NPU de tu SoC.
Gestionemos Abrir Kanban
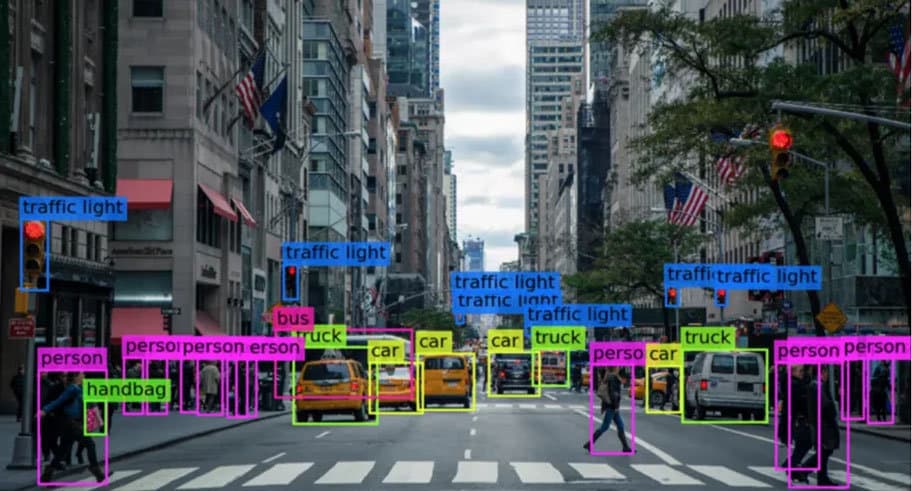
Visión por computadora ejecutándose en un dispositivo edge

01 / Qué resuelve

Productos que reaccionan por sí solos.

01

Ver y actuar en tiempo real

Detecta, cuenta y sigue lo que importa en la imagen de la cámara al instante, desde un pequeño sensor Cortex-M hasta un rig Jetson multicámara.

02

Responde a la voz, sin manos

Palabras de activación, comandos de voz y alertas de sonido gestionados en el dispositivo, sin enviar audio a ningún sitio.

03

Detecta problemas antes de que cuesten dinero

Mantenimiento predictivo, reconocimiento de gestos y actividad leídos directamente de los sensores a bordo.

04

Sigue mejorando después de salir al mercado

Un único bucle de datos a entrenamiento, evaluaciones en el dispositivo y actualizaciones over-the-air, para que el producto mejore sobre el terreno.

02 / Stack

La tecnología con la que construimos.

Estándar del sector, aburrida en el buen sentido: herramientas con futuro, que el próximo ingeniero también conocerá.

Runtimes de inferencia

  • TensorFlow Lite / LiteRT

    Modelos cuantizados en MCUs y SoCs móviles

  • ONNX Runtime

    Inferencia portable entre CPUs, GPUs y NPUs

  • TensorRT & DeepStream

    Pipelines de visión acelerados por GPU en Jetson

  • Edge Impulse & TinyML

    Iteración rápida de modelos para targets con recursos limitados

Hardware objetivo

  • Cortex-M with CMSIS-NN

    Detección de palabras clave y anomalías en kilobytes

  • NVIDIA Jetson

    Visión multicámara en el edge

  • Google Coral / Hailo

    Aceleradores dedicados para inferencia de bajo consumo

  • Qualcomm & NXP NPUs

    Aceleración en el propio SoC en dispositivos de producción

Pipeline de modelos

  • PyTorch

    Entrenamiento, destilación y exportación

  • Quantisation & pruning

    Modelos INT8 / INT4 que mantienen su precisión

  • Evals on-device

    Precisión, latencia y consumo medidos en el target

  • OTA model delivery

    Modelos entregados y revertidos como firmware

03 / Enfoque

Cómo construimos cosas que perduran.

01

Medido en el target

Latencia, memoria y consumo de corriente se miden en el dispositivo real, en cada revisión del modelo.

02

Miliwatts, no watts

Inferencia por ciclos de trabajo y aceleradores elegidos según el presupuesto de energía real del producto.

03

Privado por diseño

Los datos en bruto permanecen en el dispositivo; solo sale lo que el producto necesita, si es que sale algo.

04

Un solo pipeline, del dispositivo a la nube

Los datos de la flota alimentan el entrenamiento; un modelo mejor vuelve como una actualización ordinaria.

04 / Estándares

Buenas prácticas que no omitimos.

Seguimos estándares del sector y métodos probados en cada proyecto: son los que hacen que el presupuesto se mantenga.

  • Empieza por el modelo más pequeño que pueda funcionar: modelos pequeños destilados o cuantizados antes que los grandes
  • Entrenamiento consciente de la cuantización antes de trucos post-entrenamiento
  • Evaluaciones de precisión sobre capturas reales del dispositivo, no sobre el set de laboratorio
  • Presupuestos de latencia y energía fijados como criterios de aceptación
  • Comportamiento de respaldo definido para salidas de baja confianza
  • Versionado de modelos y reversión a través del canal OTA
  • Monitorización de deriva con la telemetría de la flota y reentrenamiento enviado por OTA
  • Revisión de privacidad de cada señal que sale del dispositivo

05 / Infraestructura

Dónde se ejecuta y cómo se mantiene en pie.

  • Bancos de benchmarking en el dispositivo (latencia, memoria, consumo)
  • Pipeline de entrenamiento alimentado por datos de la flota
  • Entrega de modelos por OTA con reversión
  • Monitoreo de drift y precisión en producción

Buenas preguntas

Lo que nos preguntan

Respuestas directas a lo que preguntan los clientes antes de empezar.

Sí, si el hardware lo permite. WNC empieza por el modelo más pequeño que resuelve la tarea —destilado o cuantizado— y lo despliega en NVIDIA Jetson y NPU similares, con presupuestos de latencia y consumo como criterios de aceptación.

Trabajo relacionado

Dónde ya lo hemos hecho

Proyectos y productos nuestros en los que intervino este servicio.

Hirske Dzherelo
IoT · Fabricación

Hirske Dzherelo

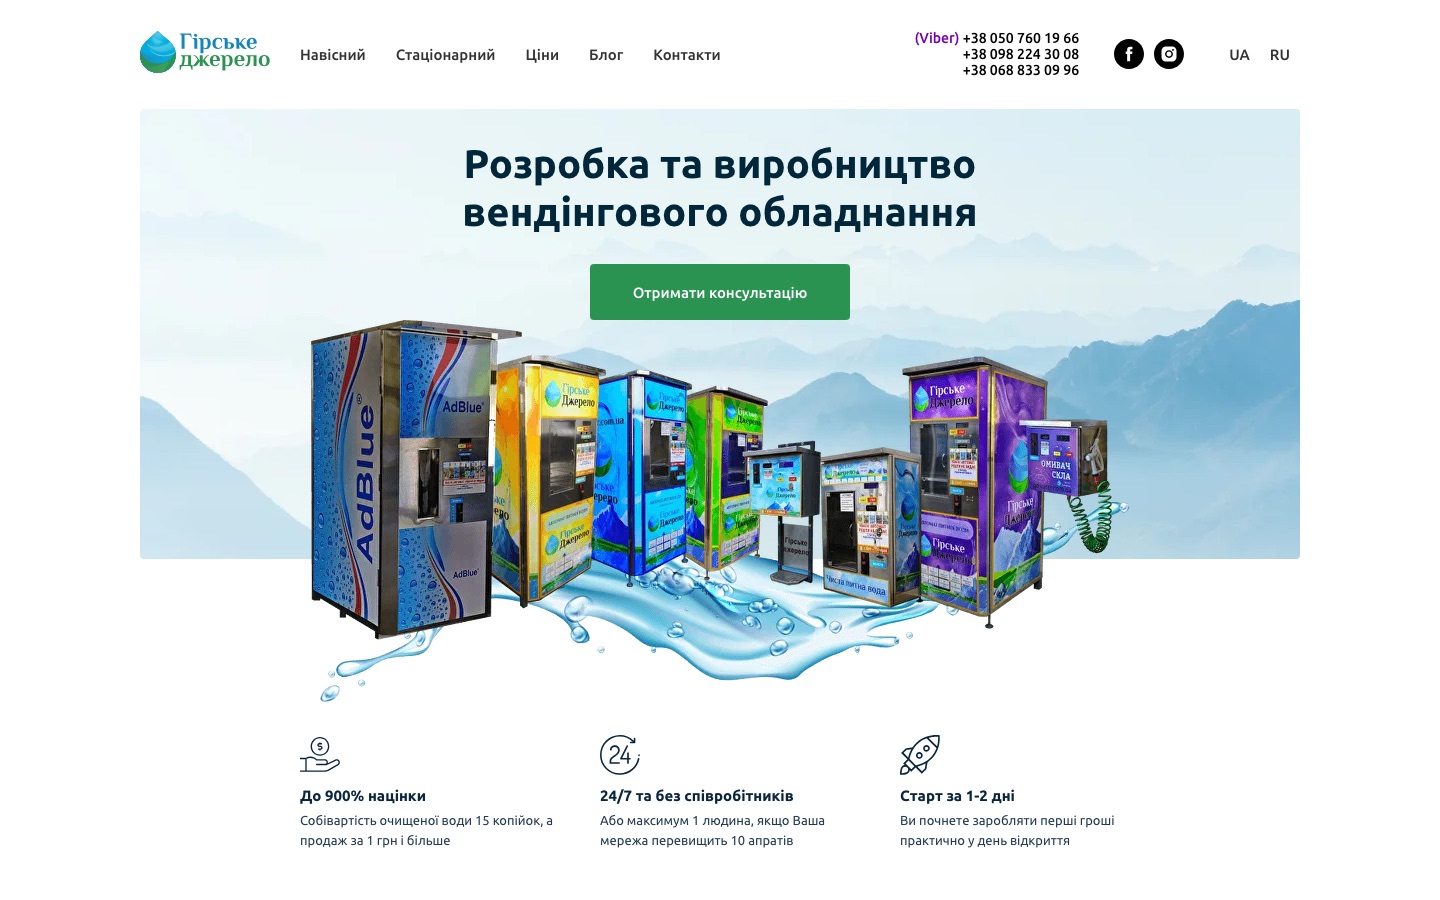
IoT para una fábrica de máquinas expendedoras de agua potable: cada máquina informa al servidor cada 3–5 segundos y se supervisa y ajusta a distancia desde un panel web y un bot de Telegram.

IoT · TelecomunicacionesPlataforma de inteligencia de servicios IoT para operadores móviles
IoT · Telecomunicaciones

Plataforma de inteligencia de servicios IoT para operadores móviles

De la conectividad a la inteligencia: una plataforma que se sitúa sobre los sistemas existentes del operador y convierte datos dispersos de SIM, dispositivos, tráfico y servicios en visibilidad, confianza y acción para clientes empresariales.

Start

¿Quieres el modelo en el dispositivo?

Cuéntanos qué tiene que ver, oír o predecir, y en qué hardware. Un ingeniero te responderá con un alcance y un precio honestos.

Let’s manage o explora AI Labs