WNC LogoWNC
ПослугиРішенняКомпаніяAcademyLabsКонтакти
Відкрити Kanban

We No Code. We Architect.

Розпочати проєкт daniel@we-nocode.com
WNC LogoWNC

Партнер із ШІ та автоматизації. Зроблено з турботою у США, Польщі, Естонії, Бразилії та Україні.

daniel@we-nocode.com+38 (068) 758-94-22+38 (095) 411-95-37
Remote-first, по всьому світу

Рішення

  • Atflow
  • Alt Auth
  • AdCrier
  • Pastukh
  • Olymp Hill

Портали

  • Портал клієнта
  • Портал інвестора
  • Портал партнера

Компанія

  • Про нас
  • Наша команда
  • Кейси
  • Відгуки
  • Інвестиції
  • Блог
  • Новини
  • Кар’єра
  • Локації
  • Контакти

Labs

  • Miltech
  • AI Labs
  • Internet of Things
  • Robotics

Ініціативи

  • Startup Program
  • Academy
  • Olymp Hill

Послуги

Усі послуги
ШІ
  • Агентні ШІ-системи
  • ШІ-агенти та копайлоти
  • MCP-сервери
  • RAG-пайплайни
  • Голосові AI-агенти
  • ШІ-орієнтоване програмне забезпечення
  • Автоматизація робочих процесів
  • LLMOps і evals
  • Fine-tuning і моделі
  • AI для документів
  • Комп’ютерний зір
Розробка
  • Веброзробка
  • Мобільна розробка
  • Розробка SaaS і MVP
  • UI/UX і продуктовий дизайн
  • Інтеграції та API
  • Розробка e-commerce
  • Модернізація legacy-систем
  • QA та автотести
  • No-code і low-code
  • Десктопна розробка
Вбудовані системи та IoT
  • IoT-рішення
  • Прошивки для вбудованих систем
  • Вбудований Linux та SoC
  • Edge AI та TinyML
  • Бездротові технології та зв’язок
  • Прототипування обладнання
  • IoT-платформа та хмара
  • Керування флотом та OTA-оновленнями
  • Промисловий IoT (IIoT)
  • Безпека IoT
Хмара та дані
  • Інженерія даних
  • Хмарна ШІ-інфраструктура
  • Серверна розробка
  • DevOps і платформи
  • Міграція і FinOps
  • BI і дашборди
  • Аналітика продуктивності
  • Підтримка і SRE
Безпека
  • Пентест
  • AI red teaming
  • Відповідність вимогам
  • Автентифікація
  • Безпека хмари
  • Безпечна розробка
  • Ланцюг постачання ПЗ
  • Аудити безпеки
  • Моніторинг безпеки
  • Архітектура zero trust
  • Приватність і GDPR
Консультування
  • Консалтинг та дорадчі послуги
  • CTO як сервіс
  • AI-стратегія і governance
  • Технічний due diligence
  • Виділена команда
  • Навчання ШІ для компаній
R&D / інновації
  • Підтвердження концепції та здійсненність
  • Швидке прототипування
  • Прикладні дослідження ШІ
  • Пошук і розвідка технологій

© 2026 WNC. Усі права захищено.

🇺🇦Разом з Україною

We No Code

Усі послуги

LLMOps, evals і guardrails

AI-функції, які можна виміряти й яким можна довіряти.

Evals, трасування, guardrails і контроль витрат: операційний шар для LLM-застосунків.

Запустити AI-функцію найпростіше. Справжня робота починається, коли її треба тримати точною, безпечною й доступною за ціною, поки змінюються промпти, моделі й дані. Ми налаштовуємо операційний шар навколо ваших LLM-застосунків: набори evals і LLM-as-a-judge, що оцінюють кожен реліз, трасування, яке показує, що модель бачила й робила, guardrails, що ловлять небезпечні запити й відповіді, і контроль витрат і затримки з маршрутизацією моделей. Якість вимірюється, а не припускається.
Почнімо керувати Відкрити Kanban
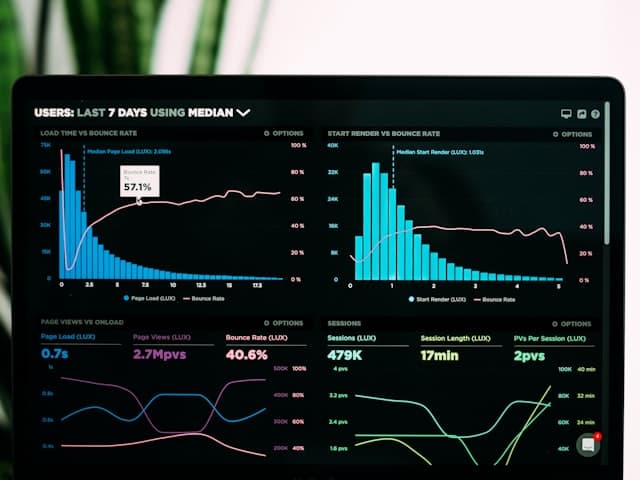
LLMOps dashboards: evals, traces and costs of AI features

01 / Що це вирішує

Від «на демо наче працювало» до виміряної якості.

01

Evals на кожному релізі

Еталонні набори даних і судді, що оцінюють точність, обґрунтованість, тон і дотримання правил, тож зміна промпту чи моделі не погіршить усе непомітно.

02

Видно кожен крок

Трасування промптів, пошуку, викликів інструментів і відповідей, прив’язане до користувачів і версій, для швидкого налагодження.

03

Guardrails, що тримають

Перевірки на prompt injection, витік даних, відхід від теми й небезпечний контент на вході й на виході.

04

Витрати й затримка під контролем

Вартість кожного запиту й функції, кешування й маршрутизація на менші моделі, де це не шкодить якості.

02 / Стек

Технології, на яких ми будуємо.

Галузеві стандарти, нудні у хорошому сенсі: інструменти з майбутнім, які знатиме й наступний інженер.

Трасування й observability

  • Langfuse

    Відкрите трасування й аналітика LLM

  • OpenTelemetry

    Нейтральний до вендорів стандарт телеметрії

  • MLflow

    Відстеження експериментів і оцінювання

  • Arize Phoenix

    Відкрита observability для LLM

Оцінювання

  • LLM-as-a-judge

    Оцінювання моделлю за чіткими критеріями

  • Golden datasets

    Тестові набори з реального трафіку

  • Promptfoo

    Тестування промптів і регресій у CI

  • Ragas

    Метрики якості пошуку й RAG

Guardrails і контроль

  • Guardrail models

    Перевірки безпеки на вході й виході

  • LLM gateway

    Єдина точка для маршрутизації, лімітів і ключів

  • Prompt registry

    Версійовані промпти з відкатом

  • Semantic caching

    Повторне використання відповідей на повторні запитання

03 / Підхід

Як ми створюємо те, що служить довго.

01

Спершу визначити якість

Разом із вами домовляємось, що таке хороша відповідь, і перетворюємо це на критерії й тест-кейси, перш ніж щось налаштовувати.

02

Evals у CI

Кожна зміна промптів, моделей чи даних проганяє набір; регресія блокує реліз, як упалий тест.

03

Правильна модель під задачу

Маршрутизація відправляє прості запити на малі дешеві моделі, а складні на найсильніші, з резервними варіантами.

04

Сповіщення про дрейф

Оцінювання вибірки живого трафіку й сповіщення, коли зсуваються якість, витрати чи затримка.

04 / Стандарти

Найкращі практики, якими ми не нехтуємо.

У кожному проєкті ми дотримуємося галузевих стандартів і перевірених методів. Саме завдяки їм оцінка залишається реалістичною.

  • Еталонні набори з реального трафіку користувачів
  • Судді, відкалібровані за розміткою людей
  • Версії промптів і моделей у кожному трейсі
  • Приховування персональних даних у логах і трейсах
  • Тести на prompt injection і витік даних
  • Бюджети й ліміти для кожної функції
  • Резервні моделі на випадок збоїв
  • Черга перевірки людиною для невпевнених відповідей

05 / Інфраструктура

Де воно працює і як лишається доступним.

  • Трасування кожного виклику LLM та інструментів
  • Набір evals у CI та на вибірці продакшн-трафіку
  • LLM-шлюз з маршрутизацією, кешем і бюджетами
  • Дашборди й сповіщення про якість, витрати й затримку

Слушні питання

Про що нас питають

Прямі відповіді на те, що клієнти питають перед стартом.

Бо їхня поведінка змінюється, коли ви правите промпт, міняєте модель чи оновлюєте дані, а звичайні тести цього не помічають. Evals перетворюють «наче працює» на виміряну якість (точність, обґрунтованість, тон, дотримання правил), яку перевіряють перед кожним релізом.

Пов’язані роботи

Де ми це вже робили

Наші проєкти й продукти, у яких була ця послуга.

Pastukh
Наш продукт

Pastukh

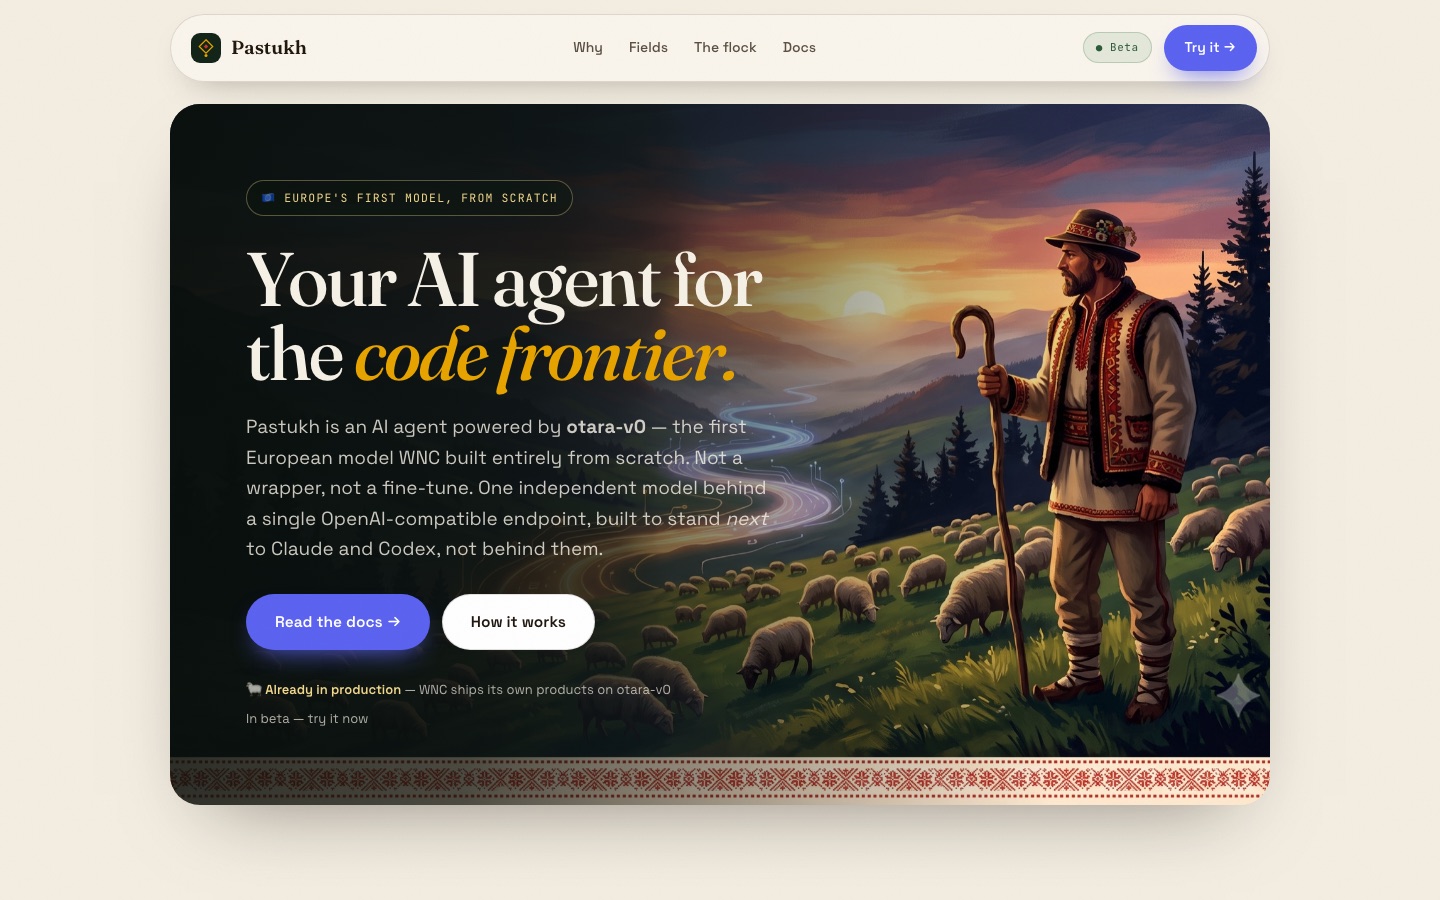
ШІ-агент для програмування на otara-v0, моделі, яку WNC створила з нуля (не обгортка й не донавчання), за одним OpenAI-сумісним ендпоінтом. У бета-версії.

AdCrier
Наш продукт

AdCrier

Спонсорські відповіді з оплатою за клік. Двосторонній маркетплейс, що поєднує ШІ-застосунки, які хочуть заробляти, з рекламодавцями, які хочуть дістатися їхніх користувачів: пряме CPC-торгування, таргетинг за категоріями, без сторонніх мереж.

ШІ-агент підтримки + дашборд для автовиробника
ШІ-агенти · Підтримка клієнтів

ШІ-агент підтримки + дашборд для автовиробника

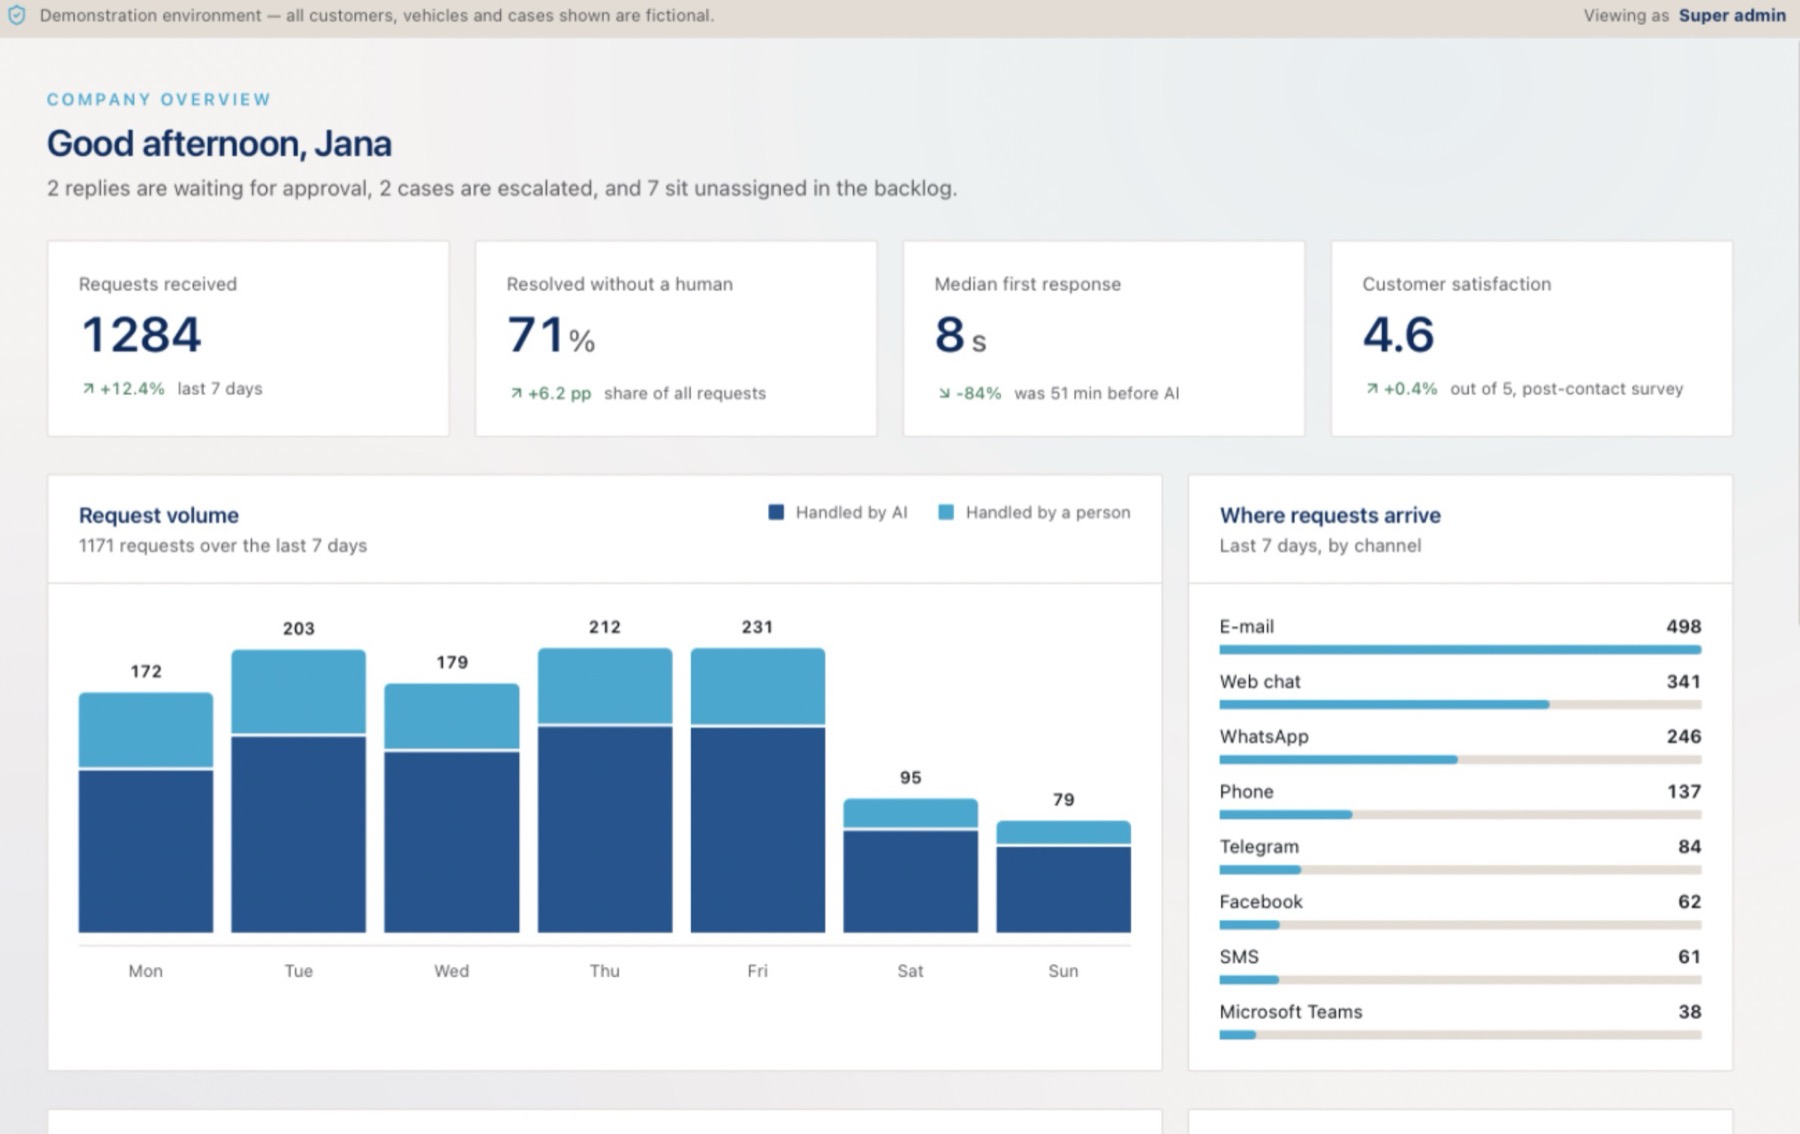
Кожне звернення клієнта ШІ читає й класифікує, автоматично підтягує дані автомобіля й готує чернетку відповіді. Нічого не йде клієнтові, доки агент не погодить.

Start

Готові дізнатися, наскільки добрий ваш AI насправді?

Розкажіть, які AI-функції у вас працюють. Старший інженер відповість чесною оцінкою обсягу й ціни.

Let’s manage Аналітика продуктивності