Периферійний ШІ та TinyML
Миттєві відповіді, без рахунків за хмару та без даних, що покидають пристрій.
Коли продукт має реагувати тієї ж миті, як щось стається, похід до хмари надто повільний, надто дорогий і перестає працювати, щойно обривається зв’язок. Ми ставимо модель на сам пристрій: він відповідає за мілісекунди, працює офлайн, а дані, які він зчитує, не мусять нікуди покидати руки клієнта. Це моделі з наших AI Labs, пристосовані під мікроконтролер, Jetson чи NPU у вашому SoC.
01 / Що це вирішує
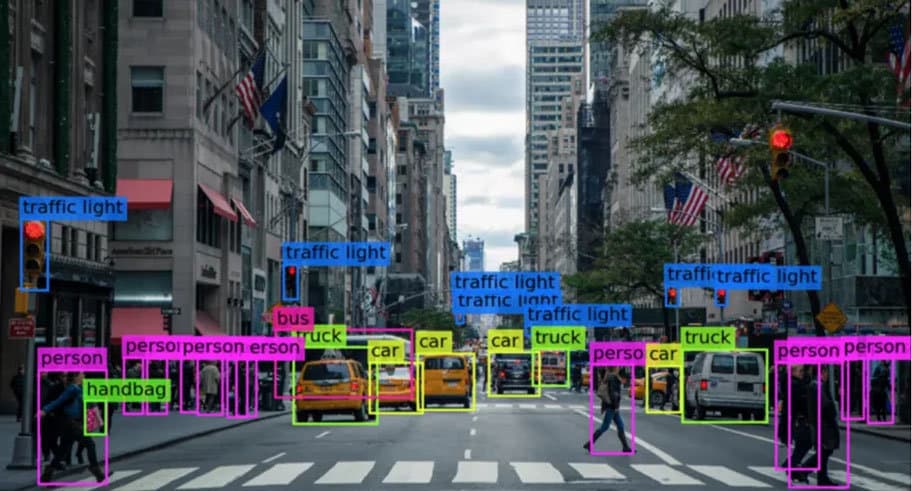
Миттєво помічайте, рахуйте й відстежуйте те, що важливо, у відеопотоці: від крихітного сенсора на Cortex-M до багатокамерної системи на Jetson.
Слова-активатори, голосові команди та звукові сповіщення опрацьовуються на пристрої, без надсилання аудіо будь-куди.
Прогнозоване обслуговування, розпізнавання жестів і активності зчитуються просто з бортових сенсорів.
Один цикл від даних до навчання, оцінювання на пристрої й оновлень по повітрю, тож продукт покращується в польових умовах.
02 / Стек
Галузеві стандарти, нудні у хорошому сенсі: інструменти з майбутнім, які знатиме й наступний інженер.
Середовища інференсу
TensorFlow Lite / LiteRT
Квантовані моделі на MCU та мобільних SoC
ONNX Runtime
Портативний інференс на CPU, GPU та NPU
TensorRT & DeepStream
Пайплайни зору з прискоренням на GPU на Jetson
Edge Impulse & TinyML
Швидка ітерація моделей для обмежених цілей
Цільове обладнання
Cortex-M with CMSIS-NN
Розпізнавання ключових слів і виявлення аномалій у кілобайтах
NVIDIA Jetson
Багатокамерний зір на периферії
Google Coral / Hailo
Виділені прискорювачі для низьковольтного інференсу
Qualcomm & NXP NPUs
Прискорення на SoC у серійних пристроях
Пайплайн моделей
PyTorch
Навчання, дистиляція та експорт
Quantisation & pruning
Моделі INT8 / INT4, що зберігають точність
Evals on-device
Точність, затримка й енергоспоживання, виміряні на цілі
OTA model delivery
Моделі доставляються й відкочуються, як прошивка
03 / Підхід
Затримка, пам’ять і споживаний струм вимірюються на реальному пристрої для кожної ревізії моделі.
Інференс із циклічним режимом роботи та прискорювачі, дібрані під той енергобюджет, який продукт справді має.
Сирі дані лишаються на пристрої; назовні йде лише те, що потрібно продукту, якщо взагалі щось іде.
Дані з парку живлять навчання; краща модель повертається назад як звичайне оновлення.
04 / Стандарти
У кожному проєкті ми дотримуємося галузевих стандартів і перевірених методів. Саме завдяки їм оцінка залишається реалістичною.
05 / Інфраструктура
Слушні питання
Прямі відповіді на те, що клієнти питають перед стартом.
Так, якщо дозволяє залізо. WNC починає з найменшої моделі, яка справляється із задачею (дистильованої або квантованої), і розгортає її на NVIDIA Jetson та подібних NPU, а бюджети затримки й енергоспоживання стають критеріями приймання.
Пов’язані роботи
Наші проєкти й продукти, у яких була ця послуга.
Start
Розкажіть, що вона має бачити, чути чи прогнозувати і на якому обладнанні. Інженер відповість із чесним обсягом робіт і ціною.
Let’s manage або дослідіть AI Labs